
INDICE
La rete delle GPU è l’insieme di collegamenti, switch e protocolli che consentono alle GPU di scambiarsi dati tra loro, sia all’interno di un server che all’interno di un cluster. Nell’addestramento dell’intelligenza artificiale, questa rete è importante tanto quanto le GPU stesse. Le GPU devono sincronizzare i propri risultati più volte durante ogni fase di addestramento, quindi un collegamento lento o malfunzionante può bloccare l’intero processo.
Esploreremo il funzionamento delle reti GPU partendo dall'architettura fino ad arrivare al livello fisico: come comunicano le GPU all'interno di un server, come sono collegati tra loro i cluster e quali cavi e connessioni in fibra ottica trasportano il traffico.
Perché i cluster di GPU necessitano di una rete diversa
Una rete tradizionale di data center gestisce numerosi flussi indipendenti: richieste web, interrogazioni di database, trasferimenti di file. Un cluster di addestramento dell’IA si comporta in modo diverso.
Quando un modello viene addestrato su più GPU, ciascuna GPU elabora una parte del lavoro e poi condivide i risultati con le altre tramite operazioni collettive. La libreria NCCL di NVIDIA, ad esempio, offre le funzioni AllReduce, AllGather, ReduceScatter e AlltoAll. In un’operazione AllReduce, i dati provenienti da ogni GPU vengono combinati (ad esempio sommati) e il risultato viene restituito a tutte le GPU. Secondo Meta, questa sincronizzazione “richiede il trasferimento di grandi quantità di dati tra le GPU nell’arco di pochi millisecondi, ripetuto per più iterazioni fino a quando il modello non converge”.”
Ne derivano due conseguenze:
- È l'anello più debole a dettare il ritmo. Un’operazione collettiva termina solo quando tutti i partecipanti hanno completato la propria parte. Un percorso congestionato o un collegamento che richiede un continuo riaddestramento rallenta tutte le GPU coinvolte nel processo.
- La latenza prevedibile è importante tanto quanto la larghezza di banda effettiva. Una rete con un throughput medio elevato ma con ritardi imprevedibili comporta comunque uno spreco di tempo della GPU.
Anche i guasti contano. Durante un periodo di 54 giorni di pre-addestramento di Llama 3 405B, Meta ha registrato 466 interruzioni del lavoro. Di queste, 47 erano pianificate e 419 inaspettate. Le “interruzioni impreviste” sono state causate in 35 casi da «switch di rete/cavi» (8,41 TP3T) e in altri 7 casi dalle schede di rete (NIC) (1,71 TP3T). Le GPU difettose e la memoria delle GPU hanno rappresentato cause più rilevanti, eppure il team è comunque riuscito a ottenere un tempo di addestramento effettivo superiore a 90%. Non stiamo dicendo che le reti siano il problema principale. Stiamo dicendo che, su questa scala, i cavi e gli switch si guastano con una frequenza tale da renderne necessaria la pianificazione.
Scale-up vs. Scale-out
Il networking basato su GPU presenta due livelli che spesso vengono confusi.
| Ampliamento | Scale-out | |
|---|---|---|
| Ambito di applicazione | GPU all’interno di un server o di un dominio su scala rack | GPU presenti in diversi server e rack |
| Tecnologia tipica | NVLink e NVSwitch | InfiniBand o Ethernet (RoCE) |
| Esempio di larghezza di banda | 900 GB/s per GPU (NVLink, Hopper); 1.800 GB/s (Blackwell) | Fino a 400 Gb/s per scheda di rete (ConnectX-7); 800 Gb/s (ConnectX-8) |
| Supporti fisici | Circuiti stampati, cavi NVLink e backplane | Cavi in rame, cavi attivi, ricetrasmettitori ottici e fibra ottica |
Prestare attenzione alle unità di misura: i dati relativi a NVLink sono espressi in gigabyte al secondo, mentre le porte di rete sono indicate in gigabit al secondo. I due livelli svolgono funzioni diverse e non sono in concorrenza tra loro. Lo scale-up collega strettamente tra loro le GPU di un singolo nodo o rack. Lo scale-out consente a migliaia di questi nodi di funzionare come un unico cluster.

Le quattro reti all’interno di un data center dedicato all’intelligenza artificiale
Un cluster di intelligenza artificiale gestisce solitamente diverse reti separate. L'architettura di riferimento DGX SuperPOD di NVIDIA per i sistemi H100 ne definisce quattro:
- Struttura di calcolo (back-end). Questa rete gestisce il traffico da GPU a GPU tra i nodi. Ogni sistema DGX H100 dispone di otto schede ConnectX-7 per questa rete, con una velocità massima di 400 Gb/s ciascuna, accessibili tramite quattro porte OSFP. Ciò equivale a una scheda di rete per ogni GPU. I server di addestramento Grand Teton di Meta seguono la stessa mappatura 1:1 tra GPU e schede di rete.
- Struttura di archiviazione. Questo processo inserisce i dati di addestramento e salva i checkpoint. Il progetto SuperPOD prevede che l’I/O per nodo “debba superare i 40 GBps”.”
- Gestione in banda. Questo collega i servizi che gestiscono il cluster, quali la pianificazione dei lavori, i repository di codice e le fonti di dati. Nel DGX H100, lo storage e il traffico in-band utilizzano due schede ConnectX-7 a doppia porta.
- Gestione fuori banda. Questo collegamento raggiunge il BMC di ciascun server per l’alimentazione, il monitoraggio e il ripristino. Sul DGX H100 si tratta di una porta RJ45 da 1 GbE, separata dalle altre reti.
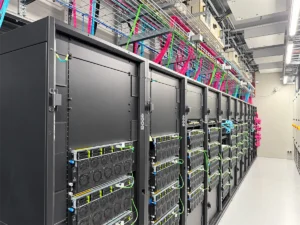
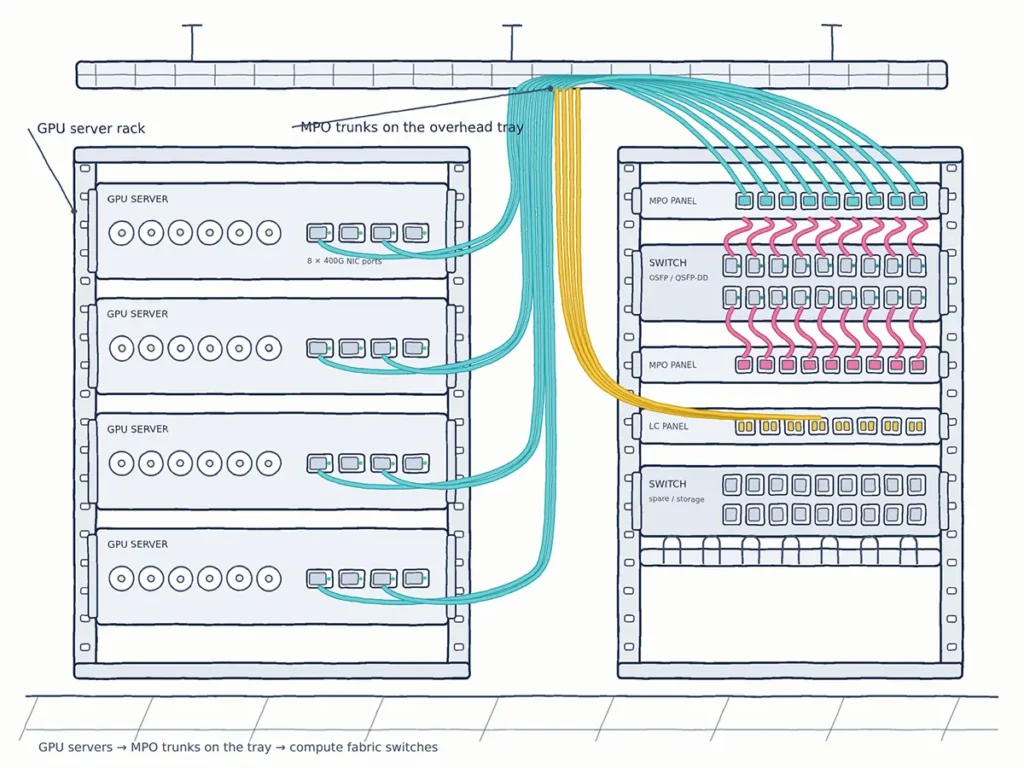
Tenere separate queste reti consente di isolare i guasti e di mantenere prevedibile il traffico di addestramento. Per quanto riguarda il cablaggio, ciò significa che ogni server GPU potrebbe necessitare di otto o più collegamenti ottici ad alta velocità solo per l'elaborazione, oltre a connessioni separate per lo storage e la gestione.
Progettazione della struttura back-end: topologia, binari e trasporto senza perdite
Design ottimizzato per la struttura a spirale e il binario
La maggior parte delle strutture back-end delle GPU utilizza una topologia leaf-spine (Clos). I cluster di GPU introducono un’ulteriore raffinatezza denominata ottimizzazione delle rotaie, ovvero l'allineamento dei rail. In un server con otto GPU, la GPU 1 si collega a uno switch leaf, la GPU 2 a un altro e così via. L'insieme di tutte le porte “GPU 1” presenti in un gruppo di server forma un rail.
Nel DGX H100 SuperPOD, ogni unità scalabile (SU) da 32 nodi è allineata su un rail. Come afferma NVIDIA, il traffico su un rail “è sempre a un hop di distanza dagli altri 31 nodi di una SU”, mentre il traffico tra rail o SU “attraversa lo strato spine”. Il progetto di riferimento completo collega 127 nodi. L’allineamento su rail mantiene la maggior parte del traffico collettivo su percorsi brevi e prevedibili. Funziona al meglio quando lo scheduler dei processi è a conoscenza della topologia.
InfiniBand contro RoCE
La struttura scale-out utilizza in genere uno dei due protocolli di trasporto RDMA:
- InfiniBand è stato progettato appositamente per il calcolo ad alte prestazioni. È dotato di controllo della congestione e instradamento adattivo integrati ed è da tempo la soluzione predefinita nei progetti di riferimento NVIDIA.
- RoCE (RDMA su Ethernet convergente) esegue RDMA su switch Ethernet. Meta utilizza RoCE su larga scala. Ha condiviso progetti per cluster composti da un massimo di 32.000 GPU, e una variante di grandi dimensioni di Llama 3 è stata addestrata su 16.000 GPU in un cluster RoCE da 24.000 GPU.
Il RoCE richiede un'attenta messa a punto. Meta ha riferito di aver utilizzato il controllo di flusso prioritario (PFC) basato su DSCP con un'unica coda “lossless”. Inizialmente ha provato il controllo di congestione DCQCN, per poi spostare la gestione della congestione all'interno della libreria collettiva stessa. In questo contesto, il termine "lossless" indica un obiettivo di progettazione che dipende dalla configurazione end-to-end, non una garanzia che i pacchetti non vengano mai persi.
L'Ethernet per l'IA è ancora in fase di sviluppo. L'Ultra Ethernet Consortium ha pubblicato l'11 giugno 2025 la specifica UEC 1.0, che copre l'intero stack, dalle schede di rete (NIC) e dagli switch ai componenti ottici e ai cavi. Si tratta di una nuova specifica, che non sostituisce ancora nessuna delle due opzioni sopra citate.
Dal tessuto ai collegamenti fisici: cavi, componenti ottici e connettori
È proprio qui che lo schema architettonico si congiunge con il percorso dei cavi, ed è qui che vediamo molte implementazioni di IA andare in crisi.
Tipi di link. I cluster GPU utilizzano diversi tipi di cavi. I cavi in rame passivi (DAC) e quelli in rame attivi (ACC o AEC) sono utilizzati per tratte molto brevi all’interno di un rack o verso un rack adiacente. I cavi ottici attivi (AOC) coprono tratte fisse più lunghe. Per i collegamenti tra file e sale, e per qualsiasi collegamento che si desideri ricollegare in un secondo momento, i cluster utilizzano ricetrasmettitori ottici innestabili con cablaggio in fibra strutturato. I limiti di portata dipendono dal prodotto specifico, quindi è consigliabile verificare le specifiche di ciascun fornitore piuttosto che basarsi su una regola empirica.
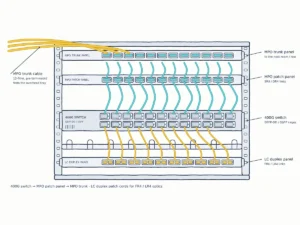
Cerchiamo di renderlo più concreto. Sugli switch InfiniBand ed Ethernet da 400G raffreddati ad aria di NVIDIA, ogni alloggiamento OSFP ospita due porte da 400 Gb/s. Il corrispondente ricetrasmettitore a doppia porta da 800G contiene due motori DR4 ed è dotato di due connettori monomodali MPO-12/APC, uno per ogni porta da 400G, ciascuno dei quali utilizza otto fibre (quattro in trasmissione e quattro in ricezione). NVIDIA indica una portata massima di 500 m e precisa che la lunghezza del cavo di 100 m “presuppone la presenza di due pannelli di permutazione ottici nel collegamento”. Sul lato server, ogni porta ConnectX-7 da 400G richiede un modulo ottico DR4 corrispondente. Il risultato è un gran numero di collegamenti in modalità singola MPO-12/APC. Per sapere come i moduli ottici DR4 e altri moduli da 400G si mappano sulla fibra, consulta il nostro Guida alla rete 400G.

La vera sfida è la scala. Se si moltiplicano gli otto collegamenti di calcolo per server per centinaia di server, aggiungendo gli uplink spine, lo storage e i sistemi di gestione, il numero di fibre aumenta rapidamente. Non esiste un dato di settore affidabile relativo alle “fibre per GPU”, poiché dipende dalla topologia. Calcolatelo in base al vostro progetto: nodi × porte per nodo × fibre per porta, più trunk, pannelli di permutazione e ricambi. I problemi pratici sono la densità, il percorso dei cavi, l’etichettatura e il mantenimento della pulizia di migliaia di estremità MPO.
È qui che la qualità del cablaggio si riflette sulle prestazioni del cluster. I cavi MPO/MTP a bassa perdita lasciano un margine nel budget di perdita per i pannelli di permutazione. Una polarità uniforme e una corretta configurazione dei pin evitano che i collegamenti rimangano semplicemente inattivi. Connettori puliti e controllati riducono gli errori di collegamento e le fluttuazioni che rallentano le operazioni collettive.
Problemi comuni delle reti GPU e come individuarli tempestivamente
Ecco i problemi che riscontriamo più spesso, partendo dal livello fisico e procedendo verso l’alto:
- Link che lampeggiano o mostrano un numero di errori in aumento. Inizia dal livello fisico. Ispeziona e pulisci entrambe le facce terminali, reinserisci il modulo ottico e verifica il percorso della fibra e la polarità. Non azzerare i contatori prima di averne preso nota. Un aumento degli errori corretti dal FEC non implica necessariamente che il connettore sia sporco, ma è la causa più economica da escludere.
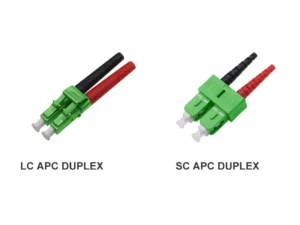
- Alcune corsie o alcuni scali rimangono chiusi. Verificare la modalità della porta e la configurazione del connettore, l'accoppiamento con o senza pin, il metodo di polarità e la mancata corrispondenza tra APC e UPC.
- Portata inferiore alle aspettative, senza guasti evidenti. Esaminate il bilanciamento del traffico tra le linee ferroviarie e i collegamenti principali, le impostazioni relative alla congestione e l’assegnazione dei compiti. Gli ingegneri sui forum segnalano che durante le sessioni di addestramento si verifica una perdita di throughput senza che vi siano errori dal lato del machine learning. Considerate questi casi come aneddoti piuttosto che come dati statistici, ma dimostrano comunque che vale la pena controllare innanzitutto la rete.
- Problemi interni al server. La guida alla risoluzione dei problemi dei cluster di AMD consiglia di verificare “lo stato del collegamento PCIe su tutti i dispositivi presenti nel percorso di trasmissione dei pacchetti dati dalla CPU alla scheda di rete”. Un collegamento PCIe compromesso può apparire esattamente come un problema di rete.
- Blocchi difficili da riprodurre. Il tracciamento a livello collettivo è utile. Il team Llama 3 di Meta ha utilizzato la registrazione dei flussi NCCL per acquisire i metadati collettivi e i tempi in cui i processi si bloccavano.
Prima della messa in funzione, Verificare la perdita di inserzione su ogni collegamento, controllare la polarità, etichettare entrambe le estremità di ogni cavo e registrare i contatori di errore di riferimento. La futura risoluzione dei problemi dipenderà da tale valore di riferimento.
Connettività passiva per cluster di GPU di YingFeng
Il successo o il fallimento dei cluster di intelligenza artificiale dipende da migliaia di piccole connessioni ripetitive. YingFeng vanta oltre 25 anni di esperienza nella produzione di fibre ottiche e realizza i componenti passivi di tali collegamenti:
- Cavi di collegamento e cavi multipli MPO/MTP in versioni da 8, 12, 16 e 24 fibre, comprese quelle a bassa perdita, prodotte in camera bianca.
- LC e altri cavi di collegamento duplex per l'archiviazione, la gestione e i collegamenti di tipo FR4.
- Kit di connettori e componenti per gli assemblatori che realizzano autonomamente il cablaggio per sistemi di intelligenza artificiale, con utensili personalizzati a disposizione.
Comunicateci le dimensioni del vostro cluster e l'elenco dei ricetrasmettitori e vi aiuteremo a definire una distinta base (BOM) adeguata per i cavi di collegamento. Offriamo servizi OEM/ODM e forniamo campioni su richiesta. Consultate anche la nostra soluzioni in fibra ottica per data center.
Domande frequenti
Che cos’è il networking GPU?
Il networking delle GPU è l'interconnessione che consente alle GPU di scambiarsi dati, sia all'interno di un server (NVLink/NVSwitch) che tra server (InfiniBand o Ethernet/RoCE). Nell'addestramento dell'IA, gestisce le operazioni collettive che mantengono sincronizzate tutte le GPU.
Qual è la differenza tra "scale-up" e "scale-out"?
Lo scale-up collega le GPU all’interno di un server o di un dominio a livello di rack con una larghezza di banda molto elevata, ad esempio 900 GB/s per GPU con Hopper NVLink. Lo scale-out collega numerosi server tramite un fabric di rete, in genere a una velocità compresa tra 400 e 800 Gb/s per scheda di rete.
Qual è la soluzione migliore per i cluster di GPU: InfiniBand o Ethernet?
Entrambe le tecnologie sono utilizzate su larga scala. InfiniBand offre un sistema integrato e consolidato di controllo della congestione. La tecnologia RoCE su Ethernet ha dato prova della propria efficacia su larga scala presso operatori come Meta, ma richiede un’attenta messa a punto. La scelta più appropriata dipende dalla scala operativa, dalle competenze disponibili e dalla strategia del fornitore.
Che cos’è una rete ottimizzata per il trasporto ferroviario?
In una rete ottimizzata per i rail, le GPU con lo stesso numero in ciascun server si collegano allo stesso switch leaf. Nel DGX H100 SuperPOD di NVIDIA, ciò consente di mantenere il traffico all’interno di un’unità da 32 nodi a un solo hop di distanza su ciascun rail.
Quali cavi collegano i server GPU agli switch?
Dipende dalla distanza. I cavi DAC in rame o i cavi in rame attivi sono adatti a collegamenti molto brevi all’interno del rack. Per collegamenti più lunghi, i cluster utilizzano ricetrasmettitori ottici, spesso 400G DR4 con cavi di collegamento monomodali MPO-12/APC, oppure cavi ottici attivi.
Riferimenti esterni
- Architettura di riferimento NVIDIA DGX SuperPOD H100, strutture di rete: https://docs.nvidia.com/dgx-superpod/reference-architecture-scalable-infrastructure-h100/latest/network-fabrics.html
- Operazioni collettive NVIDIA NCCL: https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html
- Meta, “RDMA su Ethernet per l'addestramento distribuito dell'IA su scala Meta” (SIGCOMM 2024)
- “The Llama 3 Herd of Models”, arXiv:2407.21783
- Ultra Ethernet Consortium, annuncio della specifica 1.0 (11 giugno 2025)