
ОГЛАВЛЕНИЕ
Сетевая инфраструктура графических процессоров (GPU) представляет собой совокупность каналов связи, коммутаторов и протоколов, которые позволяют графическим процессорам обмениваться данными друг с другом как внутри одного сервера, так и в пределах всего кластера. При обучении моделей искусственного интеллекта эта сеть имеет такое же важное значение, как и сами графические процессоры. Графические процессоры должны синхронизировать свои результаты многократно на каждом этапе обучения, поэтому даже одно медленное или неисправное соединение может задержать выполнение всего задания.
Мы рассмотрим сетевые технологии для графических процессоров, начиная с архитектуры и заканчивая физическим уровнем: как графические процессоры взаимодействуют внутри сервера, как соединяются кластеры, а также какие кабели и оптоволоконные соединения обеспечивают передачу трафика.
Почему кластерам на базе графических процессоров требуется иная сеть
В традиционной сети центра обработки данных передается множество независимых потоков: веб-запросы, запросы к базам данных, передача файлов. Кластер для обучения ИИ работает иначе.
Когда модель обучается на нескольких графических процессорах, каждый из них выполняет часть вычислений, а затем обменивается результатами с остальными посредством совокупные операции. Например, библиотека NCCL от NVIDIA предоставляет функции AllReduce, AllGather, ReduceScatter и AlltoAll. При использовании AllReduce данные со всех графических процессоров объединяются (например, суммируются), а результат передается обратно на все из них. По словам представителей Meta, такая синхронизация “требует передачи больших объемов данных между графическими процессорами за миллисекунды, что повторяется в течение нескольких итераций до тех пор, пока модель не сходится”.”
Из этого вытекают два следствия:
- Темп определяет самое медленное звено. Задание завершается только тогда, когда все участники завершили работу. Даже один перегруженный путь или звено, которое постоянно переобучается, замедляет работу каждого графического процессора в задании.
- Предсказуемая задержка имеет такое же значение, как и номинальная пропускная способность. Сеть с высокой средней пропускной способностью, но непредсказуемыми задержками по-прежнему приводит к потере времени работы графического процессора.
Сбои тоже имеют значение. За 54-дневный период предварительного обучения модели Llama 3 405B компания Meta зафиксировала 466 прерываний заданий. Из них 47 были запланированными, а 419 — непредвиденными. На долю “сетевых коммутаторов/кабелей” пришлось 35 непредвиденных прерываний (8,41 TP3T), а на сетевые карты — ещё 7 (1,71 TP3T). Более значительными причинами стали неисправные графические процессоры и память графических процессоров, но, несмотря на это, команде удалось достичь эффективного времени обучения более 90%. Мы не утверждаем, что сети являются основной проблемой. Мы говорим о том, что при таких масштабах кабели и коммутаторы выходят из строя достаточно часто, чтобы необходимо было планировать меры на этот случай.
Вертикальное масштабирование против горизонтального масштабирования
Сетевая архитектура графического процессора состоит из двух уровней, которые часто путают.
| Расширение масштабов | Горизонтальное масштабирование | |
|---|---|---|
| Область применения | Графические процессоры внутри сервера или в среде на уровне стойки | Графические процессоры в различных серверах и стойках |
| Типичная технология | NVLink и NVSwitch | InfiniBand или Ethernet (RoCE) |
| Пример пропускной способности | 900 ГБ/с на один графический процессор (NVLink, Hopper); 1 800 ГБ/с (Blackwell) | До 400 Гб/с на одну сетевую карту (ConnectX-7); 800 Гб/с (ConnectX-8) |
| Физические носители | Печатные платы, кабели NVLink и объединительные платы | Медные кабели, активные кабели, оптические приемопередатчики и оптоволокно |
Обратите внимание на единицы измерения: показатели NVLink выражаются в гигабайтах в секунду, тогда как скорость сетевых портов измеряется в гигабитах в секунду. Эти два уровня выполняют разные задачи и не конкурируют друг с другом. Масштабирование по вертикали обеспечивает тесную связь между графическими процессорами одного узла или стойки. Масштабирование по горизонтали позволяет тысячам таких узлов работать как единый кластер.

Четыре сети внутри центра обработки данных искусственного интеллекта
Кластер искусственного интеллекта обычно включает в себя несколько отдельных сетей. В эталонной архитектуре NVIDIA DGX SuperPOD для систем H100 определены четыре таких сети:
- Вычислительная (бэкэнд) структура. Эта сеть обеспечивает передачу трафика между графическими процессорами (GPU) различных узлов. Каждая система DGX H100 оснащена восемью адаптерами ConnectX-7 для этой сети, каждый из которых обеспечивает пропускную способность до 400 Гбит/с и подключается через четыре порта OSFP. Таким образом, на каждый графический процессор приходится по одному сетевому адаптеру. Серверы обучения Meta в центре Grand Teton используют такое же соотношение 1:1 между графическими процессорами и сетевыми адаптерами.
- Структура хранения данных. Это обеспечивает подачу обучающих данных и сохранение контрольных точек. В проекте SuperPOD указано, что пропускная способность ввода-вывода на каждый узел “должна превышать 40 ГБ/с”.”
- Управление в пределах полосы пропускания. Это обеспечивает связь между службами, обеспечивающими работу кластера, такими как система планирования заданий, репозитории кода и источники данных. В системе DGX H100 для хранения данных и внутриполосного трафика используются две двухпортовые карты ConnectX-7.
- Внеполосное управление. Этот канал подключается к модулю BMC каждого сервера для управления питанием, мониторинга и восстановления. На сервере DGX H100 это порт RJ45 со скоростью 1 Гбит/с, изолированный от остальных сетей.
Разделение этих сетей позволяет локализовать неисправности и обеспечить предсказуемость трафика при обучении. С точки зрения прокладки кабелей это означает, что каждому серверу с графическими процессорами может потребоваться восемь или более высокоскоростных оптоволоконных каналов связи только для вычислений, а также отдельные соединения для хранения данных и управления.
Проектирование бэкэнд-фабрики: топология, шины и транспорт без потерь
Конструкция, оптимизированная для листьев и рельсов
Большинство внутренних сетей графических процессоров используют топологию «лист-спойн» (Clos). В кластерах графических процессоров применяется усовершенствование, называемое оптимизация железнодорожных перевозок, или “рельс”. В сервере с восемью графическими процессорами графический процессор 1 подключается к одному листовому коммутатору, графический процессор 2 — к другому и т. д. Совокупность всех портов «GPU 1» в группе серверов образует «рельс».
В системе DGX H100 SuperPOD каждый масштабируемый блок (SU) из 32 узлов выстроен по “рельсам”. Как отмечает NVIDIA, трафик по “рельсу” «всегда находится на расстоянии одного прыжка от остальных 31 узла в SU», тогда как трафик между «рельсами» или SU «проходит через магистральный уровень». Полная эталонная архитектура объединяет 127 узлов. Выравнивание по шинам позволяет направлять большую часть совокупного трафика по коротким и предсказуемым путям. Оно работает наиболее эффективно, когда планировщик заданий знает топологию сети.
InfiniBand против RoCE
В масштабируемой сети обычно используется один из двух транспортных протоколов RDMA:
- InfiniBand специально разработан для высокопроизводительных вычислений. Он оснащён встроенными механизмами управления перегрузкой и адаптивной маршрутизацией и уже давно используется по умолчанию в эталонных проектах NVIDIA.
- RoCE (RDMA через конвергированный Ethernet) обеспечивает работу RDMA на Ethernet-коммутаторах. Meta использует RoCE в широких масштабах. Компания располагает готовыми архитектурными решениями для кластеров, насчитывающих до 32 000 графических процессоров, а обучение крупной версии модели Llama 3 проводилось на 16 000 графических процессорах в кластере RoCE, состоящем из 24 000 графических процессоров.
RoCE требует тщательной настройки. Meta сообщила об использовании управления приоритетными потоками (PFC) на основе DSCP с одной “беспроигрышной” очередью. Сначала компания попробовала механизм управления перегрузкой DCQCN, а затем перенесла управление перегрузкой в саму библиотеку collective. Термин «беспроигрышная» в данном контексте является проектной целью, зависящей от сквозной конфигурации, а не гарантией того, что пакеты никогда не будут потеряны.
Технология Ethernet для систем искусственного интеллекта продолжает развиваться. 11 июня 2025 года консорциум Ultra Ethernet Consortium опубликовал спецификацию UEC 1.0, охватывающую весь стек — от сетевых карт и коммутаторов до оптических модулей и кабелей. Речь идет о новой спецификации, которая пока не заменяет ни один из вышеупомянутых вариантов.
От ткани до физических каналов связи: кабели, оптика и разъёмы
Именно в этом месте архитектурная схема пересекается с кабельным лотком, и именно здесь мы видим, как многие проекты в области искусственного интеллекта сталкиваются с трудностями.
Типы ссылок. В кластерах графических процессоров (GPU) используются различные типы кабелей. Пассивные медные кабели (DAC) и активные медные кабели (ACC или AEC) применяются для очень коротких участков внутри стойки или для подключения к соседней стойке. Активные оптические кабели (AOC) используются для более длинных фиксированных трасс. Для соединений между рядами и помещениями, а также для любых соединений, которые впоследствии может потребоваться переподключить, в кластерах используются съемные оптические трансиверы со структурированной оптоволоконной кабельной разводкой. Пределы дальности передачи зависят от конкретной модели, поэтому следует проверять технические характеристики каждого производителя, а не полагаться на приблизительные оценки.
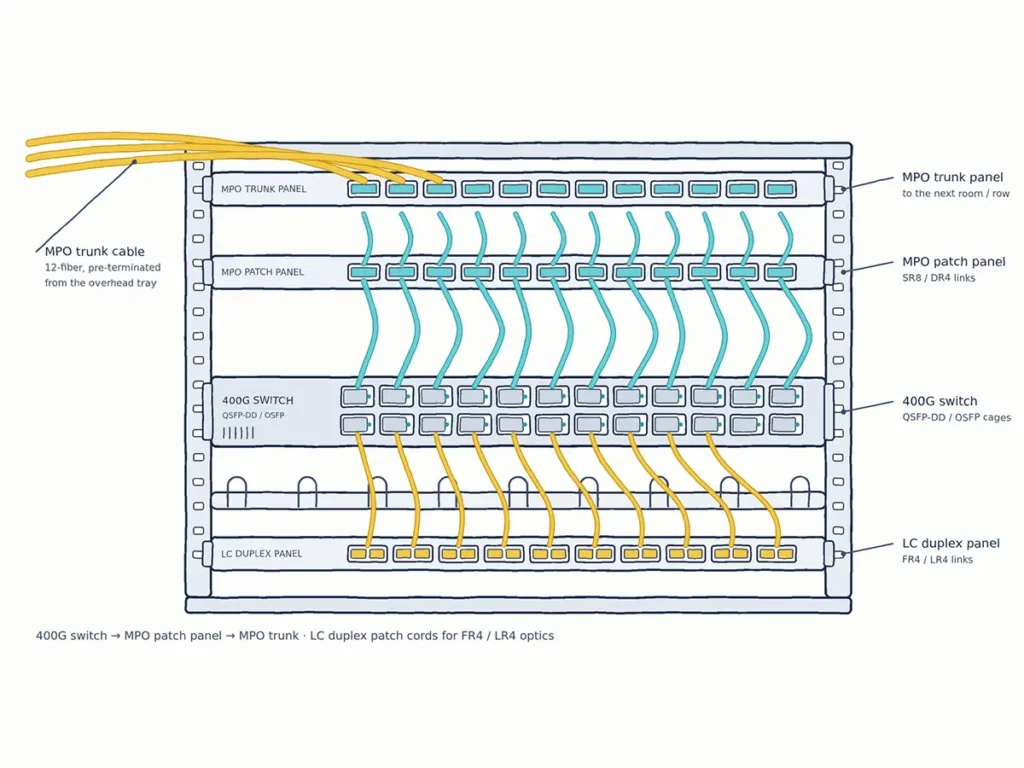
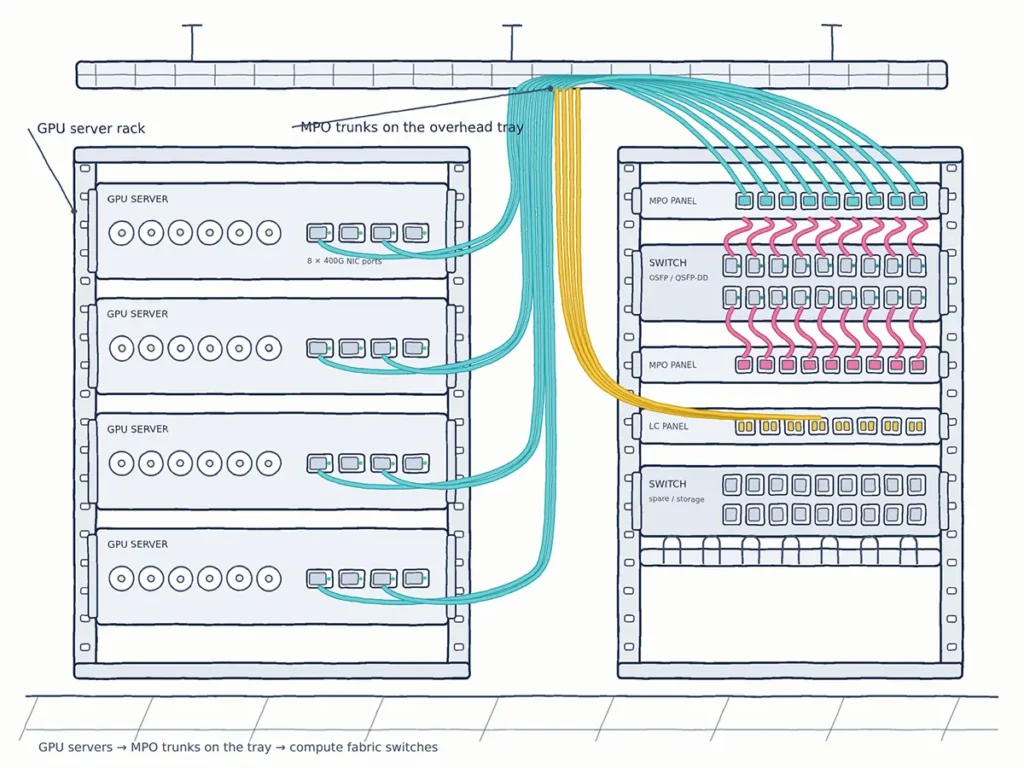
Давайте рассмотрим это на конкретном примере. В коммутаторах NVIDIA с воздушным охлаждением, поддерживающих стандарты InfiniBand и Ethernet со скоростью 400G, каждый модуль OSFP вмещает два порта со скоростью 400 Гбит/с. Соответствующий двухпортовый трансивер 800G содержит два модуля DR4 и оснащён двумя одномодовыми разъёмами MPO-12/APC — по одному на каждый порт 400G, каждый из которых использует восемь волокон (четыре для передачи, четыре для приёма). NVIDIA указывает максимальную дальность связи 500 м и отмечает, что заявленная длина кабеля 100 м “предполагает наличие двух оптических патч-панелей в кабельном канале”. На стороне сервера каждый порт 400G ConnectX-7 подключается к соответствующему оптическому модулю DR4. В результате образуется большое количество одномодовых соединений MPO-12/APC. О том, как DR4 и другие оптические модули 400G соотносятся с волокнами, см. в нашей Руководство по сети 400G.

Настоящей проблемой является масштаб. Умножьте восемь вычислительных каналов на каждый сервер на сотни серверов, добавьте каналы связи с магистралью, системы хранения данных и средства управления — и количество оптоволоконных кабелей быстро возрастет. Надежных отраслевых данных по показателю “количество волокон на один графический процессор” не существует, поскольку он зависит от топологии. Рассчитайте это исходя из вашей конструкции: количество узлов × количество портов на узел × количество волокон на порт, плюс магистральные линии, патч-панели и запасные волокна. Практические проблемы заключаются в плотности размещения, прокладке кабелей, маркировке и поддержании в чистоте тысяч торцов разъемов MPO.
Именно здесь качество кабельной разводки определяет производительность кластера. Шнуры MPO/MTP с низкими потерями оставляют запас в бюджете потерь для патч-панелей. Постоянная полярность и правильное расположение контактов предотвращают появление каналов связи, которые просто остаются неактивными. Чистые, проверенные разъемы сокращают количество ошибок в каналах связи и переключений, которые замедляют работу кластеров.
Распространенные проблемы с сетью графических процессоров и способы их раннего выявления
Вот проблемы, с которыми мы сталкиваемся чаще всего, начиная с физического уровня и далее:
- Ссылки, которые мигают или показывают растущие счетчики ошибок. Начните с физического уровня. Осмотрите и очистите обе торцевые поверхности, заново установите оптический модуль и проверьте траекторию прохождения волокна и полярность. Не сбрасывайте показания счетчиков, пока не зафиксируете их. Увеличение количества ошибок, скорректированных FEC, не всегда означает загрязнение разъема, но это самая «дешевая» причина, которую следует исключить.
- Некоторые линии или порты остаются нерабочими. Проверьте режим порта и конфигурацию разъема, соединение с закрепленными/незакрепленными контактами, метод определения полярности, а также несоответствие стандартов APC и UPC.
- Пропускная способность ниже ожидаемой, при этом явных неисправностей не обнаружено. Обратите внимание на распределение трафика по каналам и магистральным соединениям, настройки перегрузки и размещение заданий. Инженеры на форумах сообщают о тестовых прогонах, при которых наблюдается снижение пропускной способности, хотя со стороны машинного обучения ошибок не возникает. К этим сообщениям следует относиться скорее как к отдельным случаям, а не к статистике, но они показывают, что в первую очередь стоит проверить сеть.
- Проблемы внутри сервера. В руководстве AMD по устранению неисправностей в кластерных системах рекомендуется проверить “состояние соединения PCIe на всех устройствах в канале передачи пакетов между процессором и сетевой картой”. Нарушение работы соединения PCIe может выглядеть точно так же, как сетевая проблема.
- Сбои, которые трудно воспроизвести. Отслеживание на коллективном уровне помогает. Команда Llama 3 компании Meta использовала систему регистрации выполнения заданий NCCL для сбора метаданных о коллективных операциях и времени, когда задания застревали.
Перед запуском системы в эксплуатацию, Проверьте потери на вставке на каждом участке линии, убедитесь в правильности полярности, промаркируйте оба конца каждого кабеля и запишите исходные показатели счетчиков ошибок. Будущий поиск и устранение неисправностей будет зависеть от этих исходных показателей.
Пассивные системы подключения для кластеров графических процессоров от YingFeng
Эффективность кластеров искусственного интеллекта зависит от тысяч мелких, повторяющихся соединений. Компания YingFeng обладает более чем 25-летним опытом производства оптоволоконной продукции и изготавливает пассивные компоненты для этих соединений:
- Соединительные кабели и магистральные кабели MPO/MTP с количеством волокон 8, 12, 16 и 24, в том числе в исполнении с низкими потерями, изготавливаемые в чистом помещении.
- LC и другие дуплексные соединительные кабели для хранения, управления и каналов связи типа FR4.
- Комплекты разъемов и комплектующие для монтажников, занимающихся прокладкой собственных кабельных сетей для систем искусственного интеллекта, с возможностью использования специализированного инструмента.
Сообщите нам размер вашего кластера и список приемопередатчиков, и мы поможем вам составить соответствующий перечень компонентов для патч-кордов. Доступны услуги OEM/ODM; образцы предоставляются по запросу. См. также наш оптоволоконные решения для центров обработки данных.
ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ
Что такое сетевые технологии на базе графического процессора (GPU)?
Сетевые технологии для графических процессоров (GPU) представляют собой систему межпроцессорных соединений, позволяющую графическим процессорам обмениваться данными как внутри одного сервера (NVLink/NVSwitch), так и между серверами (InfiniBand или Ethernet/RoCE). При обучении моделей искусственного интеллекта они обеспечивают выполнение совокупных операций, которые поддерживают синхронизацию всех графических процессоров.
В чём заключается разница между вертикальным и горизонтальным масштабированием?
В масштабировании по вертикали графические процессоры соединяются внутри сервера или на уровне стойки с очень высокой пропускной способностью, например 900 ГБ/с на каждый графический процессор с помощью технологии Hopper NVLink. В масштабировании по горизонтали множество серверов соединяется через сетевую структуру, как правило, со скоростью 400–800 Гбит/с на каждый сетевой адаптер.
Что лучше для кластеров графических процессоров: InfiniBand или Ethernet?
Обе технологии широко используются. InfiniBand обладает отлаженным встроенным механизмом управления перегрузками. Технология RoCE в сети Ethernet доказала свою эффективность в крупных масштабах благодаря таким операторам, как Meta, однако требует тщательной настройки. Правильный выбор зависит от масштаба, имеющихся навыков и стратегии поставщика.
Что такое сеть, оптимизированная для железнодорожного транспорта?
В сети, оптимизированной по шинам, графические процессоры с одинаковыми номерами на каждом сервере подключаются к одному и тому же листьевому коммутатору. В системе NVIDIA DGX H100 SuperPOD это позволяет ограничить трафик внутри 32-узлового блока одним прыжком по каждой шине.
Какими кабелями серверы с графическими процессорами подключаются к коммутаторам?
Это зависит от расстояния. Медные DAC или активные медные кабели используются для очень коротких соединений внутри стойки. Для более длинных линий связи в кластерах применяются оптические трансиверы, чаще всего 400G DR4 с одномодовыми патч-кордами MPO-12/APC, либо активные оптические кабели.
Внешние ссылки
- Референтная архитектура NVIDIA DGX SuperPOD H100, сетевые структуры: https://docs.nvidia.com/dgx-superpod/reference-architecture-scalable-infrastructure-h100/latest/network-fabrics.html
- Коллективные операции NVIDIA NCCL: https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html
- Meta, “RDMA по Ethernet для распределенного обучения ИИ в масштабах Meta” (SIGCOMM 2024)
- “Семья моделей Llama 3”, arXiv:2407.21783
- Консорциум Ultra Ethernet, объявление о выпуске спецификации версии 1.0 (11 июня 2025 г.)