
İÇİNDEKİLER
GPU ağı, GPU’ların hem bir sunucu içinde hem de bir küme genelinde birbirleriyle veri alışverişi yapmasını sağlayan bağlantıların, anahtarların ve protokollerin bütünüdür. Yapay zeka eğitiminde bu ağ, GPU’ların kendisi kadar önemlidir. GPU’lar her eğitim adımı sırasında sonuçlarını birçok kez senkronize etmek zorundadır; bu nedenle yavaş veya arızalı tek bir bağlantı bile tüm işin ilerlemesini engelleyebilir.
Mimari düzeyden fiziksel katmana kadar GPU ağ yapısını adım adım inceleyeceğiz: GPU’ların bir sunucu içinde nasıl iletişim kurduğunu, kümelerin birbirine nasıl bağlandığını ve trafiği hangi kablolar ile fiber bağlantıların taşıdığını ele alacağız.
GPU Kümeleri Neden Farklı Bir Ağa İhtiyaç Duyar?
Geleneksel bir veri merkezi ağı, web istekleri, veritabanı sorguları ve dosya aktarımları gibi birçok bağımsız akışı taşır. Bir yapay zeka eğitim kümesi ise farklı bir şekilde çalışır.
Bir model çok sayıda GPU üzerinde eğitildiğinde, her bir GPU işin bir kısmını hesaplar ve ardından sonuçları diğerleriyle şu yol aracılığıyla paylaşır: ortak operasyonlar. Örneğin, NVIDIA’nın NCCL kütüphanesi AllReduce, AllGather, ReduceScatter ve AlltoAll işlevlerini sunar. AllReduce işleminde, her bir GPU’dan gelen veriler birleştirilir (örneğin toplanır) ve sonuç tüm GPU’lara geri gönderilir. Meta’nın ifadesiyle, bu senkronizasyon “model yakınsama noktasına ulaşana kadar, milisaniyeler içinde GPU’lar arasında büyük miktarda verinin aktarılmasını ve bu işlemin birçok yinelemede tekrarlanmasını gerektirir.”
Bundan iki sonuç ortaya çıkmaktadır:
- En yavaş halka, hızı belirler. Bir toplu iş, ancak tüm katılımcılar işlerini tamamladığında sona erer. Tıkanmış bir yol ya da sürekli yeniden eğitme işlemi yapan bir bağlantı, işteki tüm GPU’ları yavaşlatır.
- Öngörülebilir gecikme süresi, ham bant genişliği kadar önemlidir. Ortalama veri aktarım hızı yüksek ancak gecikmelerin öngörülemediği bir ağ, yine de GPU süresini boşa harcar.
Arızalar da önemlidir. Llama 3 405B’nin 54 günlük ön eğitim süreci boyunca Meta, 466 iş kesintisi kaydetti. Bunların 47“si planlı, 419”u ise beklenmedikti. Beklenmedik kesintilerin 35'i ("Ağ Anahtarı/Kablo"), 7'si ise (1,7%) ağ kartlarından kaynaklandı. Arızalı GPU’lar ve GPU belleği daha büyük sorunlar oluşturdu, ancak ekip yine de 90%’den fazla etkin eğitim süresi elde etti. Ağların asıl sorun olduğunu söylemiyoruz. Bu ölçekte kablolar ve anahtarların o kadar sık arızalandığını ve bunun için planlama yapmanız gerektiğini söylüyoruz.
Yukarı Doğru Ölçeklendirme ve Yatay Ölçeklendirme
GPU ağ yapısı, sıklıkla birbiriyle karıştırılan iki katmandan oluşur.
| Ölçek büyütme | Yayılma | |
|---|---|---|
| Kapsam | Bir sunucu veya raf ölçeğindeki bir alan içindeki GPU’lar | Farklı sunucularda ve raflarda bulunan GPU'lar |
| Tipik teknoloji | NVLink ve NVSwitch | InfiniBand veya Ethernet (RoCE) |
| Bant genişliği örneği | GPU başına 900 GB/s (NVLink, Hopper); 1.800 GB/s (Blackwell) | NIC başına en fazla 400 Gb/s (ConnectX-7); 800 Gb/s (ConnectX-8) |
| Fiziksel ortamlar | Devre kartı izleri, NVLink kabloları ve arka paneller | Bakır kablolar, aktif kablolar, optik alıcı-vericiler ve fiber |
Birimlere dikkat edin: NVLink değerleri saniyede gigabayt cinsindendir; ağ bağlantı noktaları ise saniyede gigabit cinsindendir. Bu iki katman farklı işlevlere sahiptir ve birbirleriyle rekabet etmez. Scale-up, bir düğümün veya rafın GPU’larını sıkı bir şekilde birbirine bağlar. Scale-out ise binlerce düğümün tek bir küme olarak çalışmasını sağlar.

Bir Yapay Zeka Veri Merkezi İçindeki Dört Ağ
Bir yapay zeka kümesi genellikle birkaç ayrı ağı çalıştırır. NVIDIA’nın H100 sistemleri için geliştirdiği DGX SuperPOD referans mimarisi, dört tanesini tanımlamaktadır:
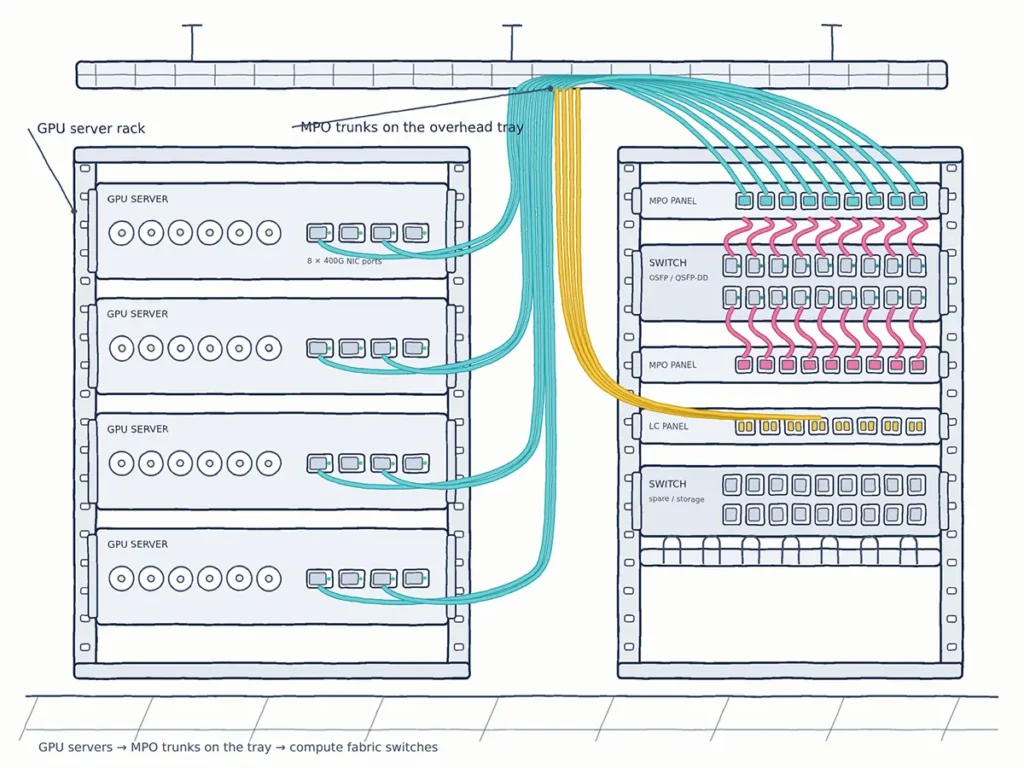
- Hesaplama (arka uç) altyapısı. Bu sistem, düğümler arasında GPU-GPU trafiğini taşır. Her bir DGX H100 sistemi, bu ağ için dört OSFP bağlantı noktası üzerinden erişilebilen, her biri 400 Gb/s’ye kadar hız sunan sekiz adet ConnectX-7 adaptörüne sahiptir. Bu, her GPU için bir ağ adaptörü anlamına gelir. Meta’nın Grand Teton eğitim sunucuları da GPU’lar ile ağ kartları arasında aynı 1:1 eşleşmesini kullanır.
- Depolama ağı. Bu işlem, eğitim verilerini sisteme besler ve kontrol noktalarını kaydeder. SuperPOD tasarımında, düğüm başına I/O’nun “40 GBps’yi aşması gerektiği” belirtilmektedir.”
- Bant içi yönetim. Bu, iş planlaması, kod depoları ve veri kaynakları gibi kümeyi çalıştıran hizmetleri birbirine bağlar. DGX H100’de depolama ve bant içi trafik, iki adet çift bağlantı noktalı ConnectX-7 kartı kullanır.
- Bant dışı yönetim. Bu bağlantı, güç, izleme ve kurtarma işlemleri için her sunucunun BMC’sine ulaşır. DGX H100’de bu bağlantı, diğer ağlardan ayrı tutulan 1 GbE RJ45 bağlantı noktasıdır.
Bu ağları birbirinden ayrı tutmak, arızaları izole eder ve eğitim trafiğinin öngörülebilir kalmasını sağlar. Kablolama açısından bu, her bir GPU sunucusunun yalnızca hesaplama işlemleri için sekiz veya daha fazla yüksek hızlı optik bağlantıya, ayrıca ayrı depolama ve yönetim bağlantılarına ihtiyaç duyabileceği anlamına gelir.
Arka Uç Ağ Tasarımı: Topoloji, Raylar ve Kayıpsız İletim
Yaprak omurgası ve ray için optimize edilmiş tasarım
Çoğu GPU arka uç yapısı, yaprak-omurga (Clos) topolojisini kullanır. GPU kümeleri, şu adı taşıyan bir geliştirme ekler: demiryolu optimizasyonu, ya da ray düzeni. Sekiz GPU’lu bir sunucuda, GPU 1 bir yaprak anahtara, GPU 2 başka bir anahtara bağlanır ve bu şekilde devam eder. Bir sunucu grubu genelinde tüm “GPU 1” bağlantı noktalarının toplamı bir ray oluşturur.
DGX H100 SuperPOD’da, 32 düğümden oluşan her bir ölçeklenebilir birim (SU), ray hizalıdır. NVIDIA’nın ifade ettiği gibi, bir ray üzerindeki trafik “her zaman bir SU’daki diğer 31 düğümden bir atlama uzaklıktadır”, oysa raylar veya SU’lar arasındaki trafik “omurga katmanından geçer”. Tam referans tasarım, 127 düğümü birbirine bağlar. Ray hizalaması, toplu trafiğin çoğunu kısa ve öngörülebilir yollarda tutar. Bu sistem, iş zamanlayıcının topolojiyi tanıdığı durumlarda en iyi şekilde çalışır.
InfiniBand ve RoCE Karşılaştırması
Ölçeklenebilir yapı genellikle iki RDMA aktarım yönteminden birini kullanır:
- InfiniBand yüksek performanslı hesaplama için özel olarak tasarlanmıştır. Yerleşik tıkanıklık kontrolü ve uyarlanabilir yönlendirme özelliklerine sahiptir ve uzun süredir NVIDIA referans tasarımlarında varsayılan seçenek olarak kullanılmaktadır.
- RoCE (Birleştirilmiş Ethernet Üzerinden RDMA) Ethernet anahtarlarında RDMA çalıştırır. Meta, RoCE’yi büyük ölçekte kullanır. 32.000 GPU’ya kadar olan kümeler için ortak tasarımlara sahiptir ve büyük bir Llama 3 varyantı, 24.000 GPU’luk bir RoCE kümesinde 16.000 GPU üzerinde eğitilmiştir.
RoCE’nin dikkatli bir şekilde ayarlanması gerekir. Meta, tek bir kayıpsız kuyruk ile DSCP tabanlı öncelikli akış kontrolü (PFC) kullandığını bildirdi. İlk olarak DCQCN tıkanıklık kontrolünü denedi, ardından tıkanıklık yönetimini kolektif kütüphanenin içine taşıdı. Bu bağlamda “kayıpsız”, paketlerin asla düşmeyeceğine dair bir garanti değil, uçtan uca yapılandırmaya bağlı bir tasarım hedefidir.
Yapay zeka için Ethernet teknolojisi hâlâ gelişme aşamasındadır. Ultra Ethernet Konsorsiyumu, 11 Haziran 2025 tarihinde, ağ kartlarından (NIC) ve anahtarlardan optik bileşenlere ve kablolara kadar tüm yığını kapsayan UEC Spesifikasyonu 1.0’ı yayınladı. Bu, yeni bir spesifikasyondur ve henüz yukarıdaki seçeneklerin hiçbirinin yerini almamaktadır.
Kumaştan Fiziksel Bağlantılara: Kablolar, Optik Bileşenler ve Konektörler
İşte mimari şeması ile kablo kanalı burada birleşiyor ve birçok yapay zeka projesinin bu noktada sorunlarla karşılaştığını görüyoruz.
Bağlantı türleri. GPU kümeleri çeşitli ortamları bir araya getirir. Pasif bakır (DAC) ve aktif bakır (ACC veya AEC) kablolar, bir rafın içindeki veya bitişik bir rafa giden çok kısa mesafelerde kullanılır. Aktif optik kablolar (AOC) ise daha uzun sabit mesafeleri kapsar. Sıralar ve odalar arasındaki bağlantılar için ve daha sonra yeniden bağlamak isteyebileceğiniz herhangi bir bağlantı için, kümeler yapılandırılmış fiber kablolama ile takılabilir optik alıcı-vericiler kullanır. Menzil sınırları ürünün türüne göre değişir; bu nedenle genel bir kural varsaymak yerine her bir üreticinin teknik özelliklerini kontrol edin.
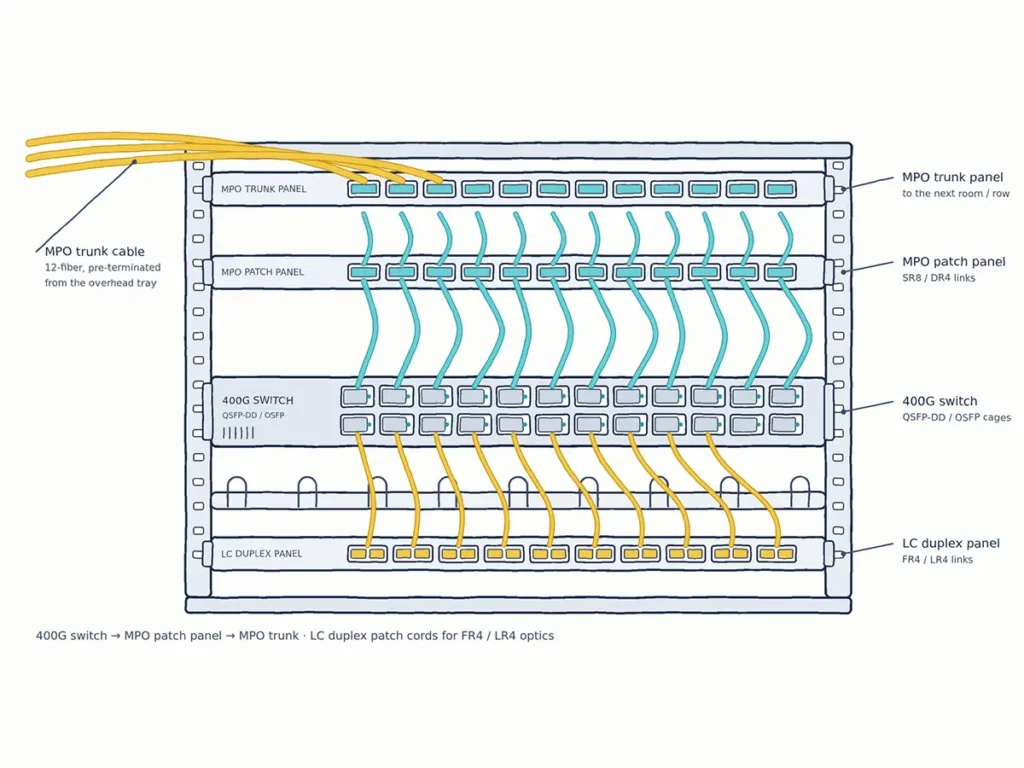
Bunu somut bir örnekle açıklayalım. NVIDIA’nın hava soğutmalı 400G InfiniBand ve Ethernet anahtarlarında, her bir OSFP yuvası iki adet 400 Gb/s bağlantı noktası barındırır. Buna uygun 800G çift bağlantı noktalı alıcı-verici, iki adet DR4 motoru içerir ve her biri sekiz fiber (dört gönderme, dört alma) kullanan, 400G bağlantı noktası başına birer tane olmak üzere iki adet MPO-12/APC tek modlu konektöre sahiptir. NVIDIA, maksimum 500 m erişim mesafesi sunar ve 100 m kablo uzunluğunun “bağlantıda iki optik patch panelinin bulunduğunu varsaydığını” belirtir. Sunucu tarafında, her bir 400G ConnectX-7 bağlantı noktası, uyumlu bir DR4 optik modül ile çalışır. Sonuç olarak, çok sayıda MPO-12/APC tek modlu bağlantı ortaya çıkar. DR4 ve diğer 400G optik modüllerinin fiberlere nasıl eşlendiği hakkında bilgi için, 400G ağ kılavuzu.

Asıl zorluk, ölçek meselesidir. Sunucu başına sekiz adet hesaplama bağlantısını yüzlerce sunucuyla çarpın, buna omurga yukarı bağlantılarını, depolama ve yönetim sistemlerini ekleyin; fiber sayısı hızla artar. “GPU başına fiber” sayısı için güvenilir bir sektör verisi yoktur, çünkü bu topolojiye bağlıdır. Tasarımınızdan hesaplayın: düğümler × düğüm başına bağlantı noktası sayısı × bağlantı noktası başına fiber sayısı, artı ana hatlar, bağlantı panelleri ve yedekler. Pratik sorunlar ise yoğunluk, kablo yönlendirme, etiketleme ve binlerce MPO uç yüzeyini temiz tutmaktır.
Kablolama kalitesinin küme performansına yansıdığı nokta budur. Düşük kayıplı MPO/MTP kabloları, kayıp bütçesinde patch paneller için yer bırakır. Tutarlı polarite ve doğru pin dizilişi, bağlantının hiç çalışmamasını önler. Temiz ve denetlenmiş konektörler, toplu işlemleri yavaşlatan bağlantı hatalarını ve dalgalanmaları azaltır.
Yaygın GPU Ağı Sorunları ve Bunların Erken Tespit Edilmesi
Fiziksel katmandan başlayarak yukarı doğru ilerlediğimizde en sık karşılaştığımız sorunlar şunlardır:
- Sallanan veya hata sayacı artışı gösteren bağlantılar. Fiziksel katmandan başlayın. Her iki uç yüzünü inceleyin ve temizleyin, optiği yerine oturtun ve fiber yolunu ve polariteyi kontrol edin. Sayıcıları kaydetmeden önce sıfırlamayın. Artan FEC düzeltmeli hatalar her zaman konektörün kirli olduğu anlamına gelmez, ancak bu, elenmesi gereken en düşük maliyetli nedendir.
- Bazı hatlar veya bağlantı noktaları devre dışı kalır. Bağlantı noktası modunu ve dağıtım konfigürasyonunu, sabitlenmiş/sabitlenmemiş bağlantı, polarite yöntemini ve APC/UPC uyumsuzluğunu kontrol edin.
- Belirgin bir arıza olmamasına rağmen iş hacmi beklentilerin altında kaldı. Demiryolları ve omurga bağlantıları arasındaki trafik dengesine, tıkanıklık ayarlarına ve iş yerleştirmeye bakın. Forumlardaki mühendisler, makine öğrenimi tarafında herhangi bir hata olmamasına rağmen eğitim çalışmalarında verim kaybı yaşadıklarını bildiriyor. Bunları istatistikten ziyade anekdotlar olarak değerlendirin; ancak bu durum, öncelikle ağın kontrol edilmesinin gerekli olduğunu gösteriyor.
- Sunucu içindeki sorunlar. AMD’nin küme sorun giderme kılavuzunda, “CPU ile ağ kartı (NIC) arasındaki paket veri yolundaki tüm aygıtlarda PCIe bağlantı durumunun” kontrol edilmesi tavsiye edilmektedir. Performansı düşmüş bir PCIe bağlantısı, tam olarak bir ağ sorunu gibi görünebilir.
- Tekrarlanması zor donma durumları. Toplu düzeydeki izleme işe yarıyor. Meta’nın Llama 3 ekibi, işlerin durma anlarındaki toplu meta verileri ve zamanlamaları yakalamak için NCCL uçuş kayıtlarını kullandı.
Sistemin devreye alınmasından önce, Her bağlantıda sinyal kaybı testini yapın, polariteyi kontrol edin, her kablonun her iki ucunu etiketleyin ve başlangıç hata sayaçlarını kaydedin. İleride yapılacak arıza giderme işlemleri bu başlangıç değerlerine dayanacaktır.
YingFeng’den GPU Kümeleri için Pasif Bağlantı Çözümü
AI kümelerinin başarısı ya da başarısızlığı, binlerce küçük ve tekrarlayan bağlantıya bağlıdır. YingFeng, 25 yılı aşkın fiber optik üretim tecrübesine sahiptir ve bu bağlantıların pasif bileşenlerini üretmektedir:
- MPO/MTP bağlantı kabloları ve ana kabloları 8, 12, 16 ve 24 fiberli seçeneklerde, düşük kayıplı versiyonlar da dahil olmak üzere, temiz odada üretilmektedir.
- LC ve diğer çift yönlü bağlantı kabloları depolama, yönetim ve FR4 tipi bağlantılar için.
- Bağlantı kitleri ve bileşenleri Kendi AI kablolama sistemlerini kuran montajcılar için; özel aletler mevcuttur.
Kümenizin boyutunu ve alıcı-verici listenizi bizimle paylaşın; size uygun bir bağlantı kablosu malzeme listesi (BOM) hazırlamanıza yardımcı olalım. OEM/ODM hizmeti sunulmaktadır ve talep üzerine numune temin edilmektedir. Ayrıca şuna da göz atın: veri merkezi fiber optik çözümleri.
SSS
GPU ağ iletişimi nedir?
GPU ağ iletişimi, GPU’ların hem bir sunucu içinde (NVLink/NVSwitch) hem de sunucular arasında (InfiniBand veya Ethernet/RoCE) veri alışverişi yapmasını sağlayan bağlantı sistemidir. Yapay zeka eğitiminde, tüm GPU’ları senkronize tutan toplu işlemleri gerçekleştirir.
“Scale-up” ile “scale-out” arasındaki fark nedir?
Scale-up, bir sunucu veya raf ölçeğindeki bir alan içindeki GPU’ları çok yüksek bant genişliğiyle birbirine bağlar; örneğin, Hopper NVLink ile GPU başına 900 GB/s. Scale-out ise birçok sunucuyu bir ağ yapısı üzerinden birbirine bağlar; bu bağlantı genellikle ağ bağdaştırıcısı başına 400–800 Gb/s hızında gerçekleşir.
GPU kümeleri için InfiniBand mı yoksa Ethernet mi daha iyidir?
Her ikisi de geniş ölçekte kullanılmaktadır. InfiniBand, olgunlaşmış bir yerleşik tıkanıklık kontrolü sunar. Ethernet üzerindeki RoCE, Meta gibi operatörler tarafından geniş ölçekte başarısı kanıtlanmıştır, ancak dikkatli bir ayarlamaya ihtiyaç duyar. Doğru seçim, ölçek, mevcut beceri düzeyleri ve tedarikçi stratejisine bağlıdır.
Demiryolu için optimize edilmiş bir ağ nedir?
Ray için optimize edilmiş bir ağda, her sunucudaki aynı numaralı GPU aynı yaprak anahtara bağlanır. NVIDIA’nın DGX H100 SuperPOD sisteminde bu düzenleme, 32 düğümlük birim içindeki trafiğin her rayda bir atlama mesafesinde kalmasını sağlar.
GPU sunucularını anahtarlara bağlayan kablolar hangileridir?
Bu, mesafeye bağlıdır. Bakır DAC veya aktif bakır kablolar, raf içi çok kısa mesafeli bağlantılarda kullanılır. Daha uzun bağlantılar için, kümelerde genellikle MPO-12/APC tek modlu bağlantı kablolarıyla birlikte 400G DR4 optik alıcı-vericiler veya aktif optik kablolar kullanılır.
Dış kaynaklar
- NVIDIA DGX SuperPOD H100 referans mimarisi, ağ yapıları: https://docs.nvidia.com/dgx-superpod/reference-architecture-scalable-infrastructure-h100/latest/network-fabrics.html
- NVIDIA NCCL toplu işlemleri: https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html
- Meta, “Meta Ölçeğinde Dağıtık Yapay Zeka Eğitimi için Ethernet Üzerinden RDMA” (SIGCOMM 2024)
- “Llama 3 Model Kümesi”, arXiv:2407.21783
- Ultra Ethernet Konsorsiyumu, 1.0 Sürümü Şartnamesi Duyurusu (11 Haziran 2025)