
INHALTSVERZEICHNIS
Unter GPU-Vernetzung versteht man die Gesamtheit der Verbindungen, Switches und Protokolle, die es GPUs ermöglichen, Daten untereinander auszutauschen – sowohl innerhalb eines Servers als auch über einen Cluster hinweg. Beim KI-Training ist dieses Netzwerk ebenso wichtig wie die GPUs selbst. GPUs müssen ihre Ergebnisse während jedes Trainingsschritts mehrfach synchronisieren, sodass bereits eine einzige langsame oder ausgefallene Verbindung den gesamten Vorgang aufhalten kann.
Wir werden die GPU-Vernetzung von der Architektur bis hin zur physikalischen Schicht durchgehen: wie GPUs innerhalb eines Servers miteinander kommunizieren, wie Cluster miteinander verkabelt sind und welche Kabel und Glasfaserverbindungen den Datenverkehr übertragen.
Warum GPU-Cluster ein anderes Netzwerk benötigen
In einem herkömmlichen Rechenzentrumsnetzwerk werden viele unabhängige Datenströme übertragen: Webanfragen, Datenbankabfragen, Dateiübertragungen. Ein KI-Trainingscluster verhält sich anders.
Wenn ein Modell auf mehreren GPUs trainiert wird, berechnet jede GPU einen Teil der Arbeit und gibt die Ergebnisse anschließend über kollektive Maßnahmen. Die NCCL-Bibliothek von NVIDIA bietet beispielsweise AllReduce, AllGather, ReduceScatter und AlltoAll. Bei einem AllReduce-Vorgang werden die Daten aller GPUs zusammengefasst (beispielsweise summiert) und das Ergebnis an alle GPUs zurückgesendet. Nach den Worten von Meta erfordert diese Synchronisation “die Übertragung großer Datenmengen zwischen den GPUs innerhalb von Millisekunden, wiederholt über mehrere Iterationen hinweg, bis das Modell konvergiert.”
Daraus ergeben sich zwei Konsequenzen:
- Das langsamste Glied bestimmt das Tempo. Ein kollektiver Rechenvorgang ist erst dann abgeschlossen, wenn alle Teilnehmer fertig sind. Ein überlasteter Pfad oder eine Verbindung, die ständig neu eingerichtet werden muss, verlangsamt jede GPU im Job.
- Eine vorhersehbare Latenz ist genauso wichtig wie die reine Bandbreite. Ein Netzwerk mit hohem durchschnittlichem Durchsatz, aber unvorhersehbaren Verzögerungen führt dennoch zu einer Verschwendung von GPU-Zeit.
Auch Ausfälle spielen eine Rolle. Während einer 54-tägigen Vortrainingsphase von Llama 3 405B verzeichnete Meta 466 Unterbrechungen der Jobs. Davon waren 47 geplant und 419 unerwartet. “Netzwerk-Switch/Kabel” waren für 35 der unerwarteten Unterbrechungen verantwortlich (8,41 TP3T), Netzwerkkarten für weitere 7 (1,71 TP3T). Defekte GPUs und GPU-Speicher waren größere Ursachen, und dennoch erreichte das Team eine effektive Trainingszeit von mehr als 901 TP3T. Wir wollen damit nicht sagen, dass Netzwerke das Hauptproblem sind. Wir wollen damit sagen, dass bei dieser Größenordnung Kabel und Switches so häufig ausfallen, dass man dies einplanen muss.
Scale-Up vs. Scale-Out
Das GPU-Netzwerk besteht aus zwei Schichten, die häufig verwechselt werden.
| Skalierung | Scale-out | |
|---|---|---|
| Geltungsbereich | GPUs in einem Server oder einer Rack-Scale-Domäne | GPUs in verschiedenen Servern und Racks |
| Typische Technologie | NVLink und NVSwitch | InfiniBand oder Ethernet (RoCE) |
| Beispiel für Bandbreite | 900 GB/s pro GPU (NVLink, Hopper); 1.800 GB/s (Blackwell) | Bis zu 400 Gb/s pro Netzwerkkarte (ConnectX-7); 800 Gb/s (ConnectX-8) |
| Physische Datenträger | Leiterbahnen, NVLink-Kabel und Backplanes | Kupferkabel, aktive Kabel, optische Transceiver und Glasfaser |
Achten Sie auf die Einheiten: Die Angaben zu NVLink lauten in Gigabyte pro Sekunde, während Netzwerkanschlüsse in Gigabit pro Sekunde angegeben werden. Die beiden Ebenen erfüllen unterschiedliche Aufgaben und stehen nicht in Konkurrenz zueinander. Bei „Scale-up“ werden die GPUs eines Knotens oder Racks eng miteinander verbunden. Bei „Scale-out“ arbeiten Tausende dieser Knoten als ein einziger Cluster zusammen.

Die vier Netzwerke in einem KI-Rechenzentrum
Ein KI-Cluster betreibt in der Regel mehrere separate Netzwerke. Die DGX SuperPOD-Referenzarchitektur von NVIDIA für H100-Systeme definiert vier davon:
- Compute-Struktur (Backend). Dieses Netzwerk überträgt den GPU-zu-GPU-Datenverkehr zwischen den Knoten. Jedes DGX-H100-System verfügt über acht ConnectX-7-Adapter für dieses Netzwerk mit einer Übertragungsrate von jeweils bis zu 400 Gb/s, die über vier OSFP-Ports bereitgestellt werden. Das entspricht einem Netzwerkadapter pro GPU. Die „Grand Teton“-Trainingsserver von Meta folgen derselben 1:1-Zuordnung zwischen GPUs und Netzwerkkarten.
- Speicherstruktur. Dadurch werden Trainingsdaten eingelesen und Checkpoints gespeichert. Laut SuperPOD-Konzept muss die I/O-Rate pro Knoten “40 GBps übersteigen”.”
- In-Band-Verwaltung. Dadurch werden die Dienste miteinander verbunden, die den Cluster betreiben, wie beispielsweise die Auftragsplanung, Code-Repositorys und Datenquellen. Im DGX H100 werden für den Speicher- und den In-Band-Datenverkehr zwei ConnectX-7-Karten mit jeweils zwei Anschlüssen verwendet.
- Out-of-Band-Verwaltung. Diese Verbindung führt zum BMC jedes Servers und dient der Stromversorgung, Überwachung und Wiederherstellung. Beim DGX H100 handelt es sich um einen 1-GbE-RJ45-Anschluss, der von den anderen Netzwerken getrennt ist.
Durch die Trennung dieser Netzwerke lassen sich Fehler isolieren und der Trainingsdatenverkehr bleibt vorhersehbar. Für die Verkabelung bedeutet dies, dass jeder GPU-Server allein für die Rechenleistung möglicherweise acht oder mehr optische Hochgeschwindigkeitsverbindungen benötigt, zuzüglich separater Speicher- und Verwaltungsverbindungen.
Backend-Fabric-Design: Topologie, Schienen und verlustfreier Transport
Für Blattfedern und Schienen optimiertes Design
Die meisten Backend-Strukturen von GPUs nutzen eine Leaf-Spine-Topologie (Clos). GPU-Cluster verfügen zusätzlich über eine Verfeinerung namens Schienenoptimierung, oder eine Rail-Anordnung. In einem Server mit acht GPUs ist GPU 1 mit einem Leaf-Switch verbunden, GPU 2 mit einem anderen und so weiter. Die Gesamtheit aller “GPU 1”-Ports einer Servergruppe bildet eine Rail.
Im DGX H100 SuperPOD ist jede skalierbare Einheit (SU) mit 32 Knoten rail-ausgerichtet. Wie NVIDIA es formuliert, ist der Datenverkehr auf einer Rail “immer nur einen Hop von den anderen 31 Knoten in einer SU entfernt”, während der Datenverkehr zwischen Rails oder SUs “die Spine-Ebene durchläuft”. Das vollständige Referenzdesign verbindet 127 Knoten. Durch die Rail-Ausrichtung verläuft der Großteil des kollektiven Datenverkehrs auf kurzen, vorhersehbaren Pfaden. Dies funktioniert am besten, wenn der Job-Scheduler die Topologie kennt.
InfiniBand vs. RoCE
Die Scale-out-Struktur nutzt in der Regel einen von zwei RDMA-Transportmechanismen:
- InfiniBand wurde speziell für Hochleistungsrechner entwickelt. Es verfügt über integrierte Überlastungskontrolle und adaptives Routing und ist seit langem der Standard in den Referenzdesigns von NVIDIA.
- RoCE (RDMA über Converged Ethernet) führt RDMA auf Ethernet-Switches aus. Meta setzt RoCE in großem Maßstab ein. Das Unternehmen verfügt über gemeinsame Designs für Cluster mit bis zu 32.000 GPUs, und eine große Variante von Llama 3 wurde auf 16.000 GPUs in einem RoCE-Cluster mit 24.000 GPUs trainiert.
RoCE erfordert eine sorgfältige Feinabstimmung. Meta berichtete, dass es eine DSCP-basierte Prioritätsflusssteuerung (PFC) mit einer einzigen verlustfreien Warteschlange einsetzte. Zunächst wurde die DCQCN-Überlastungskontrolle ausprobiert, anschließend wurde das Überlastungsmanagement in die kollektive Bibliothek selbst verlagert. “Verlustfrei” ist in diesem Zusammenhang ein Designziel, das von der End-to-End-Konfiguration abhängt, und keine Garantie dafür, dass niemals Pakete verloren gehen.
Ethernet für KI befindet sich noch in der Entwicklung. Das Ultra Ethernet Consortium hat am 11. Juni 2025 seine UEC-Spezifikation 1.0 veröffentlicht, die den gesamten Stack von Netzwerkkarten und Switches bis hin zu optischen Komponenten und Kabeln abdeckt. Es handelt sich um eine neue Spezifikation, die noch keinen Ersatz für eine der beiden oben genannten Optionen darstellt.
Vom Material bis zur physikalischen Verbindung: Kabel, Optik und Steckverbinder
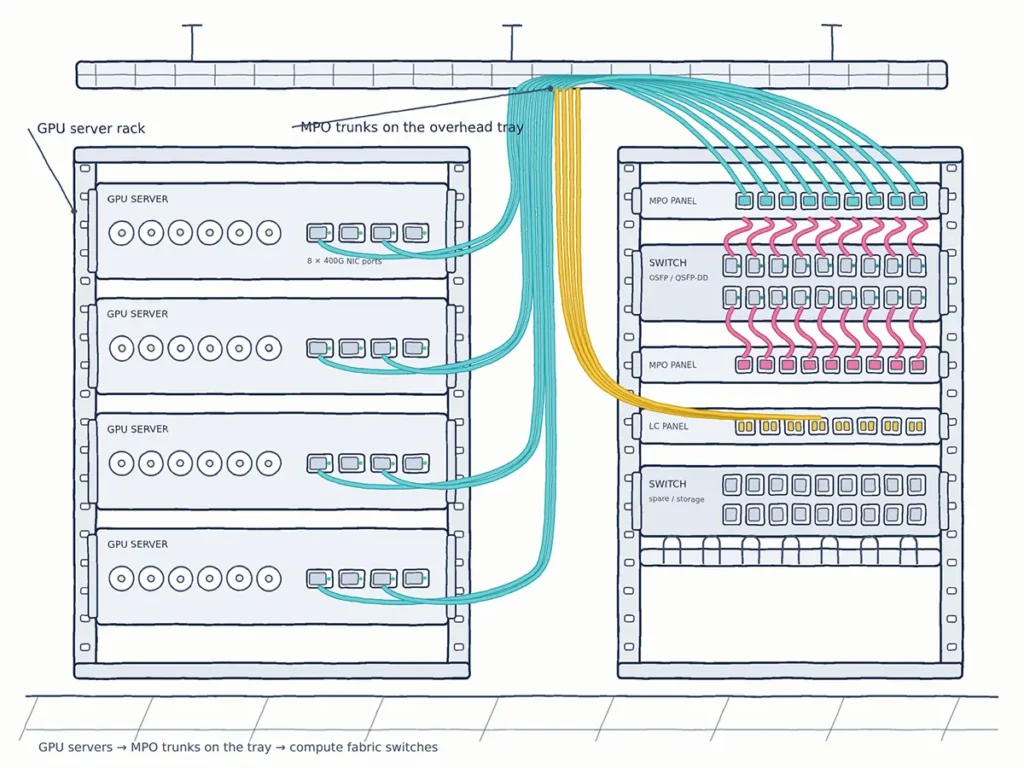
An dieser Stelle trifft das Architekturdiagramm auf die Kabelrinne, und hier sehen wir, dass viele KI-Implementierungen ins Stocken geraten.
Link-Typen. GPU-Cluster kombinieren verschiedene Medien. Passive Kupferkabel (DAC) und aktive Kupferkabel (ACC oder AEC) werden für sehr kurze Strecken innerhalb eines Racks oder zu einem benachbarten Rack verwendet. Aktive optische Kabel (AOC) decken längere feste Strecken ab. Für Verbindungen zwischen Reihen und Räumen sowie für alle Verbindungen, die später neu gepatcht werden sollen, verwenden Cluster steckbare optische Transceiver mit strukturierter Glasfaserverkabelung. Die Reichweitengrenzen hängen vom jeweiligen Produkt ab; überprüfen Sie daher die Spezifikationen der einzelnen Anbieter, anstatt von einer Faustregel auszugehen.
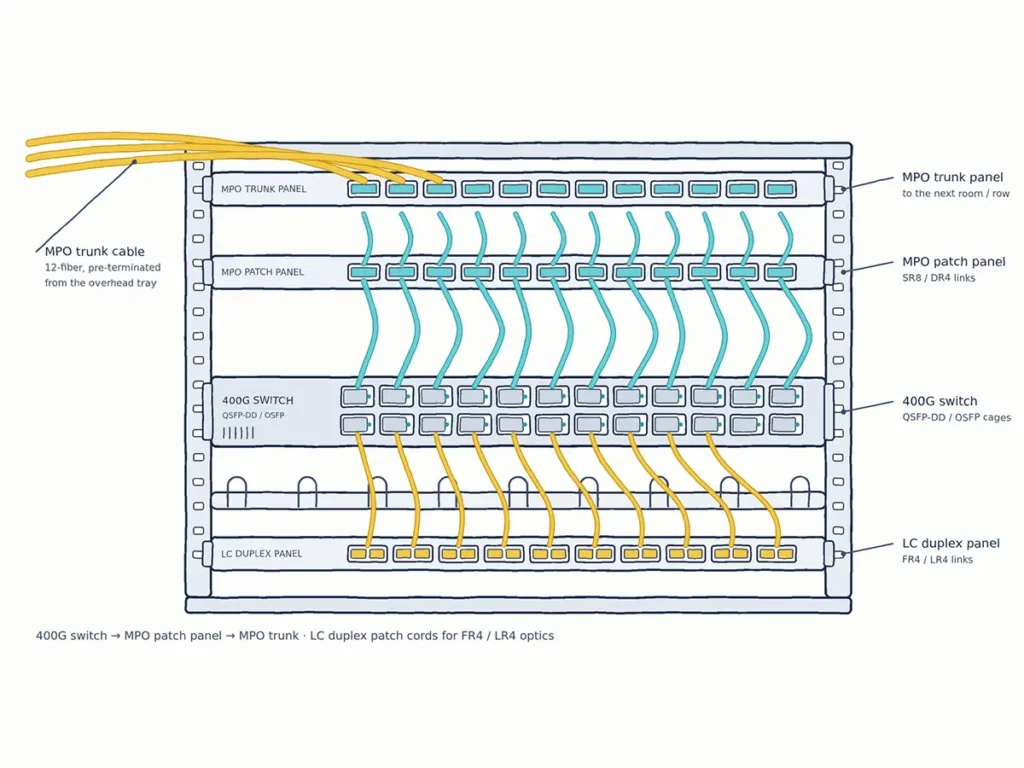
Lassen Sie uns das einmal konkretisieren. Bei den luftgekühlten 400G-InfiniBand- und Ethernet-Switches von NVIDIA verfügt jeder OSFP-Einschub über zwei 400-Gb/s-Ports. Der passende 800G-Transceiver mit zwei Anschlüssen enthält zwei DR4-Engines und verfügt über zwei MPO-12/APC-Singlemode-Anschlüsse, einen pro 400G-Port, wobei jeder acht Fasern nutzt (vier zum Senden, vier zum Empfangen). NVIDIA gibt eine maximale Reichweite von 500 m an und weist darauf hin, dass die angegebene Kabellänge von 100 m “von zwei optischen Patchpanels in der Verbindung ausgeht”. Auf der Serverseite benötigt jeder 400G-ConnectX-7-Port ein passendes DR4-Modul. Das Ergebnis ist eine große Anzahl von MPO-12/APC-Singlemode-Verbindungen. Wie DR4- und andere 400G-Module auf Glasfaser abgebildet werden, erfahren Sie in unserem Leitfaden zum 400G-Netzwerk.

Die Größe ist die eigentliche Herausforderung. Multipliziert man acht Rechenverbindungen pro Server mit Hunderten von Servern, addiert man dazu Spine-Uplinks, Speicher und Management, steigt die Anzahl der Glasfaserleitungen schnell an. Es gibt keine verlässlichen Branchenzahlen für “Glasfaser pro GPU”, da dies von der Topologie abhängt. Berechnen Sie es anhand Ihres Designs: Knoten × Ports pro Knoten × Glasfasern pro Port, zuzüglich Trunks, Patchfelder und Ersatzfasern. Die praktischen Probleme sind die Dichte, die Kabelführung, die Beschriftung und die Sauberhaltung von Tausenden von MPO-Endflächen.
Hier entscheidet die Qualität der Verkabelung über die Leistung des Clusters. Verlustarme MPO/MTP-Kabel lassen im Verlustbudget Spielraum für Patchfelder. Eine einheitliche Polarität und die korrekte Pinbelegung verhindern, dass Verbindungen einfach nicht funktionieren. Saubere, geprüfte Steckverbinder reduzieren Verbindungsfehler und Schwankungen, die die Gesamtleistung beeinträchtigen.
Häufige Probleme im GPU-Netzwerk und wie man sie frühzeitig erkennt
Hier sind die Probleme, die uns am häufigsten begegnen, beginnend bei der physikalischen Schicht:
- Links, die flackern oder steigende Fehlerzähler anzeigen. Beginnen Sie mit der physikalischen Ebene. Überprüfen und reinigen Sie beide Anschlussflächen, setzen Sie die Optik wieder ein und überprüfen Sie den Faserverlauf sowie die Polarität. Löschen Sie die Zählerstände erst, nachdem Sie diese notiert haben. Eine steigende Anzahl von FEC-korrigierten Fehlern deutet nicht immer auf einen verschmutzten Stecker hin, aber dies ist die kostengünstigste Ursache, die man ausschließen kann.
- Einige Fahrspuren oder Anschlüsse bleiben gesperrt. Überprüfen Sie den Portmodus und die Breakout-Konfiguration, die pingebundene bzw. pinunabhängige Steckverbindung, die Polaritätsmethode sowie die APC/UPC-Fehlanpassung.
- Der Durchsatz liegt unter den Erwartungen, ohne dass ein offensichtlicher Fehler vorliegt. Sehen Sie sich die Verkehrsverteilung über Rails und Spine-Verbindungen, die Einstellungen für Überlastungen und die Job-Zuweisung an. Ingenieure berichten in Foren von Trainingsläufen, bei denen der Durchsatz sinkt, obwohl auf der ML-Seite keine Fehler auftreten. Betrachten Sie dies eher als Anekdoten denn als Statistiken, aber sie zeigen, dass es sich lohnt, zunächst das Netzwerk zu überprüfen.
- Probleme im Server. Im Leitfaden zur Fehlerbehebung bei AMD-Clustern wird empfohlen, den “PCIe-Verbindungsstatus aller Geräte im Datenpfad zwischen CPU und Netzwerkkarte” zu überprüfen. Eine beeinträchtigte PCIe-Verbindung kann genau wie ein Netzwerkproblem aussehen.
- Schwer reproduzierbare Programmabstürze. Eine Nachverfolgung auf kollektiver Ebene ist hilfreich. Das Llama-3-Team von Meta nutzte die NCCL-Flugprotokollierung, um kollektive Metadaten und Zeitangaben zu erfassen, wenn Jobs ins Stocken gerieten.
Vor der Inbetriebnahme, Prüfen Sie die Einfügungsdämpfung an jeder Verbindung, überprüfen Sie die Polarität, kennzeichnen Sie beide Enden jedes Kabels und notieren Sie die Fehlerzähler der Ausgangsbasis. Die zukünftige Fehlerbehebung hängt von dieser Ausgangsbasis ab.
Passive Konnektivität für GPU-Cluster von YingFeng
KI-Cluster stehen und fallen mit Tausenden kleiner, sich wiederholender Verbindungen. YingFeng verfügt über mehr als 25 Jahre Erfahrung in der Herstellung von Glasfaserkabeln und fertigt die passiven Komponenten dieser Verbindungen:
- MPO/MTP-Patchkabel und -Verbindungskabel in Ausführungen mit 8, 12, 16 und 24 Fasern, darunter auch verlustarme Varianten, die in einem Reinraum hergestellt werden.
- LC- und andere Duplex-Patchkabel für Speicherung, Verwaltung und FR4-Verbindungen.
- Steckverbindersätze und Komponenten für Monteure, die ihre eigenen KI-Kabelkonfektionen herstellen, wobei maßgeschneiderte Werkzeuge zur Verfügung stehen.
Teilen Sie uns die Größe Ihres Clusters und die Transceiver-Liste mit, und wir helfen Ihnen bei der Erstellung einer passenden Stückliste für Patchkabel. Wir bieten OEM-/ODM-Dienstleistungen an und stellen auf Anfrage Muster zur Verfügung. Siehe auch unsere Glasfaserlösungen für Rechenzentren.
FAQ
Was versteht man unter GPU-Netzwerken?
GPU-Netzwerke sind die Verbindungsstrukturen, über die GPUs Daten austauschen können – sowohl innerhalb eines Servers (NVLink/NVSwitch) als auch zwischen Servern (InfiniBand oder Ethernet/RoCE). Beim KI-Training werden über diese Netzwerke die gemeinsamen Rechenoperationen übertragen, die für die Synchronisation aller GPUs sorgen.
Was ist der Unterschied zwischen „Scale-up“ und „Scale-out“?
Beim Scale-up werden GPUs innerhalb eines Servers oder einer Rack-Scale-Domäne mit sehr hoher Bandbreite miteinander verbunden, beispielsweise mit 900 GB/s pro GPU über Hopper NVLink. Beim Scale-out werden viele Server über eine Netzwerkarchitektur miteinander verbunden, in der Regel mit 400–800 Gb/s pro Netzwerkadapter.
Was eignet sich besser für GPU-Cluster: InfiniBand oder Ethernet?
Beide werden in großem Maßstab eingesetzt. InfiniBand bietet eine ausgereifte, integrierte Überlastungskontrolle. RoCE über Ethernet hat sich bei Betreibern wie Meta in großem Maßstab bewährt, erfordert jedoch eine sorgfältige Feinabstimmung. Die richtige Wahl hängt vom Umfang, den vorhandenen Kompetenzen und der Strategie des Anbieters ab.
Was ist ein für den Schienenverkehr optimiertes Netz?
In einem rail-optimierten Netzwerk ist die GPU mit derselben Nummer in jedem Server mit demselben Leaf-Switch verbunden. Im DGX H100 SuperPOD von NVIDIA sorgt dies dafür, dass der Datenverkehr innerhalb einer Einheit mit 32 Knoten auf jedem Rail nur einen Hop entfernt bleibt.
Mit welchen Kabeln werden GPU-Server an Switches angeschlossen?
Das hängt von der Entfernung ab. Kupfer-DACs oder aktive Kupferkabel eignen sich für sehr kurze Verbindungen innerhalb eines Racks. Für längere Verbindungen werden in Clustern optische Transceiver verwendet, häufig 400G DR4 mit MPO-12/APC-Singlemode-Patchkabeln, oder aktive optische Kabel.
Externe Verweise
- NVIDIA DGX SuperPOD H100-Referenzarchitektur, Netzwerkarchitekturen: https://docs.nvidia.com/dgx-superpod/reference-architecture-scalable-infrastructure-h100/latest/network-fabrics.html
- NVIDIA NCCL-Kollektivoperationen: https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html
- Meta, “RDMA über Ethernet für verteiltes KI-Training im Meta-Maßstab” (SIGCOMM 2024)
- “The Llama 3 Herd of Models”, arXiv:2407.21783
- Ultra Ethernet Consortium, Bekanntgabe der Spezifikation 1.0 (11. Juni 2025)