
ÍNDICE DE CONTEÚDO
A rede de GPUs é o conjunto de links, switches e protocolos que permite que as GPUs troquem dados entre si, tanto dentro de um servidor quanto entre os componentes de um cluster. No treinamento de IA, essa rede é tão importante quanto as próprias GPUs. As GPUs precisam sincronizar seus resultados várias vezes durante cada etapa do treinamento; portanto, um link lento ou com falha pode atrasar todo o trabalho.
Vamos abordar as redes de GPU, desde a arquitetura até a camada física: como as GPUs se comunicam dentro de um servidor, como os clusters são interconectados e quais cabos e conexões de fibra transportam o tráfego.
Por que os clusters de GPUs precisam de uma rede diferente
Uma rede tradicional de data center transporta diversos fluxos independentes: solicitações da web, consultas a bancos de dados, transferências de arquivos. Um cluster de treinamento de IA se comporta de maneira diferente.
Quando um modelo é treinado em várias GPUs, cada GPU calcula uma parte do trabalho e, em seguida, compartilha os resultados com as outras por meio de operações coletivas. A biblioteca NCCL da NVIDIA, por exemplo, oferece AllReduce, AllGather, ReduceScatter e AlltoAll. Em um AllReduce, os dados de todas as GPUs são combinados (por exemplo, somados), e o resultado é enviado de volta para todas elas. Nas palavras da Meta, essa sincronização “requer a transferência de grandes quantidades de dados entre as GPUs em milissegundos, repetida ao longo de várias iterações até que o modelo converja”.”
Isso acarreta duas consequências:
- O elo mais lento determina o ritmo. Um trabalho coletivo só é concluído quando todos os participantes tiverem concluído sua parte. Um caminho congestionado ou um elo que precise ser reiniciado constantemente retarda todas as GPUs envolvidas no trabalho.
- A latência previsível é tão importante quanto a largura de banda bruta. Uma rede com alta taxa de transferência média, mas com atrasos imprevisíveis, ainda desperdiça tempo da GPU.
As falhas também são importantes. Durante um período de 54 dias de pré-treinamento do Llama 3 405B, a Meta registrou 466 interrupções de tarefas. Dessas, 47 foram planejadas e 419 foram inesperadas. “Switch/cabo de rede” foi responsável por 35 das interrupções inesperadas (8,41 TP3T), e as placas de rede (NICs), por outras 7 (1,71 TP3T). GPUs e memórias de GPU com defeito foram causas mais significativas, e a equipe ainda assim alcançou mais de 90% de tempo efetivo de treinamento. Não estamos dizendo que as redes sejam o principal problema. Estamos dizendo que, nessa escala, cabos e switches falham com frequência suficiente para que seja necessário se planejar para isso.
Expansão vertical x Expansão horizontal
A rede de GPUs possui duas camadas que costumam ser confundidas.
| Ampliação | Expansão horizontal | |
|---|---|---|
| Âmbito | GPUs dentro de um servidor ou em um domínio em escala de rack | GPUs em diferentes servidores e racks |
| Tecnologia típica | NVLink e NVSwitch | InfiniBand ou Ethernet (RoCE) |
| Exemplo de largura de banda | 900 GB/s por GPU (NVLink, Hopper); 1.800 GB/s (Blackwell) | Até 400 Gb/s por placa de rede (ConnectX-7); 800 Gb/s (ConnectX-8) |
| Mídias físicas | Trilhas de placa, cabos NVLink e backplanes | Cabos de cobre, cabos ativos, transceptores ópticos e fibra óptica |
Preste atenção às unidades de medida: os valores do NVLink são expressos em gigabytes por segundo, enquanto as portas de rede são classificadas em gigabits por segundo. As duas camadas desempenham funções diferentes e não competem entre si. A escala vertical (scale-up) interliga estreitamente as GPUs de um nó ou rack. A escala horizontal (scale-out) permite que milhares desses nós funcionem como um único cluster.

As quatro redes dentro de um data center de IA
Um cluster de IA geralmente opera várias redes independentes. A arquitetura de referência DGX SuperPOD da NVIDIA para sistemas H100 define quatro delas:
- Estrutura de computação (back-end). Isso transporta o tráfego de GPU para GPU entre os nós. Cada sistema DGX H100 possui oito adaptadores ConnectX-7 para essa rede, com velocidade de até 400 Gb/s cada, conectados por meio de quatro portas OSFP. Isso equivale a um adaptador de rede por GPU. Os servidores de treinamento Grand Teton da Meta seguem o mesmo mapeamento 1:1 entre GPUs e placas de rede.
- Estrutura de armazenamento. Isso alimenta os dados de treinamento e salva os pontos de verificação. O projeto do SuperPOD estabelece que a taxa de E/S por nó “deve exceder 40 GBps”.”
- Gerenciamento na banda. Isso conecta os serviços que operam o cluster, como o agendamento de tarefas, os repositórios de código e as fontes de dados. No DGX H100, o armazenamento e o tráfego in-band utilizam duas placas ConnectX-7 de porta dupla.
- Gerenciamento fora de banda. Essa conexão chega ao BMC de cada servidor para fins de alimentação, monitoramento e recuperação. No DGX H100, trata-se de uma porta RJ45 de 1 GbE, mantida separada das demais redes.
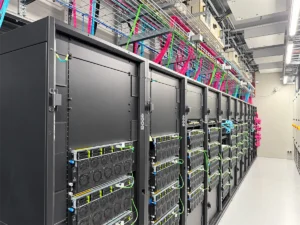
Manter essas redes separadas isola falhas e mantém o tráfego de treinamento previsível. No que diz respeito ao cabeamento, isso significa que cada servidor de GPU pode precisar de oito ou mais links ópticos de alta velocidade apenas para computação, além de conexões separadas para armazenamento e gerenciamento.
Projeto da estrutura de back-end: topologia, trilhos e transporte sem perdas
Projeto otimizado para espinha da lâmina e trilho
A maioria das estruturas de back-end de GPUs utiliza uma topologia do tipo “leaf-spine” (Clos). Os clusters de GPUs incluem um refinamento denominado otimização ferroviária, ou alinhamento de trilhos. Em um servidor com oito GPUs, a GPU 1 se conecta a um switch leaf, a GPU 2 a outro e assim por diante. O conjunto de todas as portas “GPU 1” em um grupo de servidores forma um trilho.
No DGX H100 SuperPOD, cada unidade escalável (SU) de 32 nós está alinhada por trilhos. Como explica a NVIDIA, o tráfego em um trilho “está sempre a um salto de distância dos outros 31 nós em uma SU”, enquanto o tráfego entre trilhos ou SUs “atravessa a camada de espinha dorsal”. O projeto de referência completo conecta 127 nós. O alinhamento por trilhos mantém a maior parte do tráfego coletivo em caminhos curtos e previsíveis. Isso funciona melhor quando o agendador de tarefas está ciente da topologia.
InfiniBand x RoCE
A malha de expansão horizontal normalmente utiliza um dos dois protocolos de transporte RDMA:
- InfiniBand foi projetado especificamente para computação de alto desempenho. Possui controle de congestionamento e roteamento adaptativo integrados e, há muito tempo, é a opção padrão nos projetos de referência da NVIDIA.
- RoCE (RDMA sobre Ethernet Convergente) executa RDMA em switches de Ethernet. A Meta executa RoCE em grande escala. Ela disponibilizou projetos para clusters de até 32.000 GPUs, e uma variante de grande porte do Llama 3 foi treinada em 16.000 GPUs em um cluster RoCE de 24.000 GPUs.
O RoCE requer um ajuste cuidadoso. A Meta relatou o uso do controle de fluxo por prioridade (PFC) baseado em DSCP com uma única fila sem perdas. Inicialmente, tentou o controle de congestionamento DCQCN e, em seguida, transferiu o gerenciamento de congestionamento para a própria biblioteca coletiva. “Sem perdas”, nesse contexto, é uma meta de projeto que depende da configuração de ponta a ponta, e não uma garantia de que os pacotes nunca serão descartados.
A Ethernet para IA ainda está em desenvolvimento. O Ultra Ethernet Consortium divulgou sua Especificação UEC 1.0 em 11 de junho de 2025, abrangendo a pilha desde placas de rede (NICs) e switches até componentes ópticos e cabos. Trata-se de uma nova especificação, que ainda não substitui nenhuma das opções acima.
Da estrutura à conexão física: cabos, componentes ópticos e conectores
É aqui que o diagrama de arquitetura se encontra com a bandeja de cabos, e onde vemos muitos projetos de IA enfrentarem dificuldades.
Tipos de links. Os clusters de GPU combinam diversos tipos de mídia. Cabos de cobre passivos (DAC) e ativos (ACC ou AEC) são utilizados em trechos muito curtos dentro de um rack ou para conectar a um rack adjacente. Os cabos ópticos ativos (AOC) cobrem trechos fixos mais longos. Para conexões entre fileiras e salas, e para qualquer conexão que você queira reconfigurar posteriormente, os clusters utilizam transceptores ópticos conectáveis com cabeamento de fibra estruturado. Os limites de alcance dependem do produto específico; portanto, verifique as especificações de cada fornecedor em vez de partir de uma regra geral.
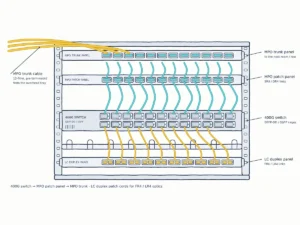
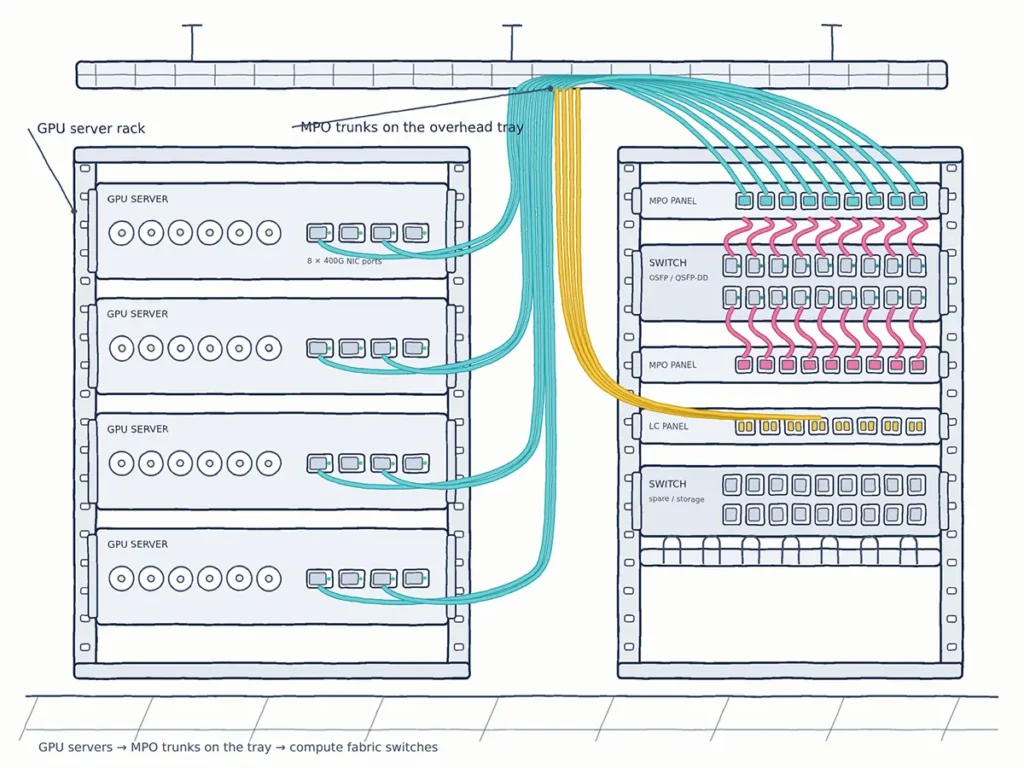
Vamos concretizar isso. Nos switches InfiniBand e Ethernet de 400G com resfriamento a ar da NVIDIA, cada compartimento OSFP comporta duas portas de 400 Gb/s. O transceptor de duas portas 800G correspondente contém dois motores DR4 e possui dois conectores MPO-12/APC de modo único, um por porta 400G, cada um utilizando oito fibras (quatro de transmissão e quatro de recepção). A NVIDIA indica um alcance máximo de 500 m e observa que o comprimento de cabo de 100 m “pressupõe dois painéis de patch ópticos no link”. No lado do servidor, cada porta 400G do ConnectX-7 aceita um módulo óptico DR4 compatível. O resultado é um grande número de links monomodo MPO-12/APC. Para saber como os módulos ópticos DR4 e outros de 400G se mapeiam para a fibra, consulte nosso Guia da rede 400G.

A escala é o verdadeiro desafio. Multiplique oito links de computação por servidor por centenas de servidores, some os uplinks para o spine, o armazenamento e o gerenciamento, e o número de fibras aumenta rapidamente. Não há um número confiável no setor para “fibras por GPU”, pois isso depende da topologia. Calcule a partir do seu projeto: nós × portas por nó × fibras por porta, mais troncos, painéis de conexão e sobressalentes. Os problemas práticos são a densidade, o traçado dos cabos, a identificação e a manutenção da limpeza de milhares de extremidades MPO.
É aqui que a qualidade do cabeamento se reflete no desempenho do cluster. Cabos MPO/MTP de baixa perda deixam margem no orçamento de perda para os painéis de conexão. A polaridade consistente e a disposição correta dos pinos evitam que os links simplesmente fiquem inativos. Conectores limpos e inspecionados reduzem os erros de link e as oscilações que tornam os conjuntos mais lentos.
Problemas comuns na rede de GPUs e como detectá-los antecipadamente
Aqui estão os problemas que observamos com mais frequência, partindo da camada física e subindo:
- Links que piscam ou exibem contadores de erros em aumento. Comece pela camada física. Inspecione e limpe ambas as faces do conector, recoloque o elemento óptico e verifique o trajeto da fibra e a polaridade. Não zere os contadores antes de registrá-los. O aumento dos erros corrigidos pelo FEC nem sempre significa que o conector esteja sujo, mas essa é a causa mais barata a ser descartada.
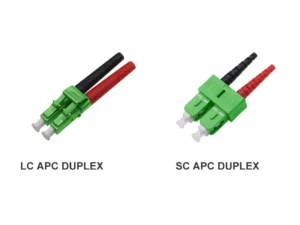
- Algumas faixas ou portos permanecem fechados. Verifique o modo da porta e a configuração do conector, o acoplamento com ou sem fixação, o método de polaridade e a incompatibilidade entre APC e UPC.
- A taxa de processamento está abaixo do esperado, sem que haja nenhuma falha aparente. Analise o equilíbrio do tráfego entre os links de trilhos e de espinha dorsal, as configurações de congestionamento e a alocação de tarefas. Engenheiros em fóruns relatam que, durante os testes de treinamento, há perda de rendimento sem que haja erros no lado do aprendizado de máquina. Considere esses relatos como anedotas, e não como estatísticas, mas eles mostram que vale a pena verificar a rede primeiro.
- Problemas no servidor. O guia de solução de problemas de cluster da AMD recomenda verificar “o status do link PCIe em todos os dispositivos no caminho de dados de pacotes entre a CPU e a placa de rede (NIC)”. Um link PCIe com desempenho reduzido pode se parecer exatamente com um problema de rede.
- Travamentos difíceis de reproduzir. O rastreamento em nível coletivo ajuda. A equipe do Llama 3 da Meta utilizou o registro de execução do NCCL para capturar metadados coletivos e os momentos em que as tarefas ficavam paralisadas.
Antes da entrada em operação, Teste a perda de inserção em cada link, verifique a polaridade, identifique ambas as extremidades de cada cabo e registre os contadores de erros de referência. O diagnóstico de problemas no futuro dependerá dessa linha de base.
Conectividade passiva para clusters de GPU da YingFeng
Os clusters de IA dependem de milhares de pequenas conexões repetitivas. A YingFeng possui mais de 25 anos de experiência na fabricação de fibra óptica e produz as peças passivas desses links:
- Cabos de conexão e troncos MPO/MTP com 8, 12, 16 e 24 fibras, incluindo versões de baixa perda, produzidas em sala limpa.
- LC e outros cabos de conexão duplex para armazenamento, gerenciamento e conexões do tipo FR4.
- Kits e componentes de conectores para montadores que fabricam seus próprios cabos para IA, com ferramentas personalizadas disponíveis.
Informe o tamanho do seu cluster e a lista de transceptores, e nós o ajudaremos a elaborar uma lista de materiais (BOM) para os cabos de conexão adequados. Oferecemos serviços de OEM/ODM e fornecemos amostras mediante solicitação. Consulte também nosso soluções de fibra óptica para data centers.
PERGUNTAS FREQUENTES
O que é rede baseada em GPU?
A rede de GPUs é a interconexão que permite que as GPUs troquem dados, tanto dentro de um servidor (NVLink/NVSwitch) quanto entre servidores (InfiniBand ou Ethernet/RoCE). No treinamento de IA, ela realiza as operações coletivas que mantêm todas as GPUs sincronizadas.
Qual é a diferença entre “scale-up” e “scale-out”?
A escalabilidade vertical conecta GPUs dentro de um servidor ou em um domínio na escala de rack com largura de banda muito alta, como 900 GB/s por GPU com o Hopper NVLink. A escalabilidade horizontal conecta vários servidores por meio de uma malha de rede, normalmente a uma velocidade de 400 a 800 Gb/s por adaptador de rede.
O que é melhor para clusters de GPU: InfiniBand ou Ethernet?
Ambas são utilizadas em grande escala. O InfiniBand oferece um controle de congestionamento integrado e maduro. O RoCE em Ethernet já foi comprovado em grande escala por operadoras como a Meta, mas requer um ajuste cuidadoso. A escolha certa depende da escala, das competências existentes e da estratégia do fornecedor.
O que é uma rede otimizada para o transporte ferroviário?
Em uma rede otimizada por rail, a GPU com o mesmo número em cada servidor se conecta ao mesmo switch leaf. No DGX H100 SuperPOD da NVIDIA, isso mantém o tráfego dentro de uma unidade de 32 nós a apenas um salto de distância em cada rail.
Quais cabos conectam os servidores de GPU aos switches?
Isso depende da distância. Os cabos DAC de cobre ou os cabos ópticos ativos são utilizados para percursos muito curtos dentro do rack. Para ligações mais longas, os clusters utilizam transceptores ópticos, geralmente 400G DR4 com cabos de conexão monomodo MPO-12/APC, ou cabos ópticos ativos.
Referências externas
- Arquitetura de referência do NVIDIA DGX SuperPOD H100, estruturas de rede: https://docs.nvidia.com/dgx-superpod/reference-architecture-scalable-infrastructure-h100/latest/network-fabrics.html
- Operações coletivas do NVIDIA NCCL: https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html
- Meta, “RDMA sobre Ethernet para treinamento distribuído de IA em escala Meta” (SIGCOMM 2024)
- “O Conjunto de Modelos Llama 3”, arXiv:2407.21783
- Consórcio Ultra Ethernet, Anúncio da Especificação 1.0 (11 de junho de 2025)