
TABLE DES MATIÈRES
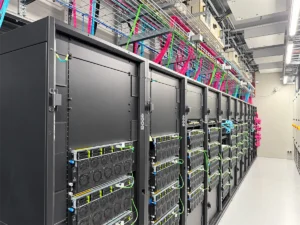
Le réseau GPU désigne l'ensemble des liaisons, commutateurs et protocoles qui permettent aux GPU d'échanger des données entre eux, tant au sein d'un serveur qu'au sein d'un cluster. Dans le cadre de l'entraînement en IA, ce réseau revêt une importance tout aussi grande que les GPU eux-mêmes. Les GPU doivent synchroniser leurs résultats à plusieurs reprises au cours de chaque étape d'entraînement ; ainsi, une liaison lente ou défaillante peut bloquer l'ensemble du traitement.
Nous allons passer en revue les réseaux de GPU, depuis l'architecture jusqu'à la couche physique : comment les GPU communiquent au sein d'un serveur, comment les clusters sont reliés entre eux, et quels câbles et connexions par fibre optique acheminent le trafic.
Pourquoi les clusters de GPU ont besoin d'un réseau différent
Un réseau de centre de données classique achemine de nombreux flux indépendants : requêtes Web, requêtes de base de données, transferts de fichiers. Un cluster d'entraînement d'IA fonctionne différemment.
Lorsqu'un modèle est entraîné sur plusieurs GPU, chaque GPU effectue une partie du travail, puis partage ses résultats avec les autres via opérations collectives. La bibliothèque NCCL de NVIDIA, par exemple, propose les fonctions AllReduce, AllGather, ReduceScatter et AlltoAll. Dans une opération AllReduce, les données provenant de chaque GPU sont combinées (par exemple, additionnées), et le résultat est renvoyé à l’ensemble des GPU. Selon Meta, cette synchronisation “ nécessite le transfert de grandes quantités de données entre les GPU en quelques millisecondes, répété sur plusieurs itérations jusqu’à ce que le modèle converge ”.”
Il en découle deux conséquences :
- C'est le maillon le plus faible qui détermine le rythme. Une tâche collective n'est terminée que lorsque tous les participants ont terminé. Un chemin encombré ou une liaison qui ne cesse de se réinitialiser ralentit tous les GPU impliqués dans la tâche.
- Une latence prévisible est tout aussi importante que la bande passante brute. Un réseau présentant un débit moyen élevé mais des délais imprévisibles entraîne tout de même un gaspillage de temps de traitement du GPU.
Les défaillances ont également leur importance. Au cours d’une période de 54 jours de pré-entraînement de Llama 3 405B, Meta a enregistré 466 interruptions de tâches. Parmi celles-ci, 47 étaient planifiées et 419 étaient imprévues. Les “ commutateurs réseau/câbles ” ont été à l’origine de 35 de ces interruptions imprévues (8,41 TP3T), et les cartes réseau (NIC) de 7 autres (1,71 TP3T). Les pannes de GPU et de mémoire GPU ont constitué des causes plus importantes, mais l’équipe a tout de même atteint plus de 901 TP3T de temps d’entraînement effectif. Nous ne disons pas que les réseaux sont le problème principal. Nous affirmons simplement qu’à cette échelle, les câbles et les commutateurs tombent suffisamment souvent en panne pour qu’il faille en tenir compte dans la planification.
Évolutivité verticale vs évolutivité horizontale
La mise en réseau des GPU comporte deux couches qui sont souvent confondues.
| Mise à l'échelle | Évolutivité horizontale | |
|---|---|---|
| Champ d'application | GPU intégrés à un serveur ou à un environnement à l'échelle d'un rack | Cartes graphiques dans différents serveurs et baies |
| Technologie typique | NVLink et NVSwitch | InfiniBand ou Ethernet (RoCE) |
| Exemple de bande passante | 900 Go/s par GPU (NVLink, Hopper) ; 1 800 Go/s (Blackwell) | Jusqu'à 400 Gb/s par carte réseau (ConnectX-7) ; 800 Gb/s (ConnectX-8) |
| Supports physiques | Circuits imprimés, câbles NVLink et fonds de panier | Câbles en cuivre, câbles actifs, émetteurs-récepteurs optiques et fibre optique |
Faites attention aux unités de mesure : les chiffres relatifs à NVLink sont exprimés en gigaoctets par seconde, tandis que ceux des ports réseau sont exprimés en gigabits par seconde. Ces deux niveaux remplissent des fonctions différentes et ne se font pas concurrence. L’architecture « scale-up » relie étroitement les GPU d’un même nœud ou d’un même rack. L’architecture « scale-out » permet à des milliers de ces nœuds de fonctionner comme un seul et même cluster.

Les quatre réseaux au sein d'un centre de données dédié à l'IA
Un cluster d'IA exécute généralement plusieurs réseaux distincts. L'architecture de référence DGX SuperPOD de NVIDIA pour les systèmes H100 en définit quatre :
- Structure de calcul (back-end). Ce réseau achemine le trafic de GPU à GPU entre les nœuds. Chaque système DGX H100 dispose de huit adaptateurs ConnectX-7 pour ce réseau, offrant chacun un débit pouvant atteindre 400 Gb/s, accessibles via quatre ports OSFP. Cela correspond à un adaptateur réseau par GPU. Les serveurs d’entraînement Grand Teton de Meta respectent le même rapport de 1:1 entre les GPU et les cartes réseau.
- Structure de stockage. Cela permet d'alimenter le système en données d'entraînement et d'enregistrer des points de contrôle. La conception de SuperPOD stipule que le débit d'E/S par nœud “ doit dépasser 40 Go/s ”.”
- Gestion en bande. Ce système relie les services qui assurent le fonctionnement du cluster, tels que la planification des tâches, les référentiels de code et les sources de données. Sur le DGX H100, le stockage et le trafic en bande sont gérés par deux cartes ConnectX-7 à double port.
- Gestion hors bande. Cette connexion relie le BMC de chaque serveur pour l'alimentation, la surveillance et la récupération. Sur le DGX H100, il s'agit d'un port RJ45 1 GbE, isolé des autres réseaux.
Le fait de séparer ces réseaux permet d'isoler les défaillances et de garantir la prévisibilité du trafic d'entraînement. En termes de câblage, cela signifie que chaque serveur GPU peut nécessiter au moins huit liaisons optiques haut débit rien que pour le calcul, auxquelles s'ajoutent des connexions distinctes pour le stockage et la gestion.
Conception du réseau back-end : topologie, rails et transport sans perte
Conception optimisée pour les essieux à ressorts à lames et les rails
La plupart des structures de interconnexion back-end des GPU utilisent une topologie « leaf-spine » (Clos). Les clusters de GPU intègrent une amélioration appelée optimisation ferroviaire, ou “ rail ”. Dans un serveur à huit GPU, le GPU 1 est connecté à un commutateur « leaf », le GPU 2 à un autre, et ainsi de suite. L’ensemble de tous les ports « GPU 1 » d’un groupe de serveurs forme un « rail ».
Dans le SuperPOD DGX H100, chaque unité évolutive (SU) de 32 nœuds est alignée sur un rail. Comme l’explique NVIDIA, le trafic sur un rail “ n’est jamais qu’à un saut des 31 autres nœuds d’une SU ”, tandis que le trafic entre les rails ou les SU “ traverse la couche spine ”. La conception de référence complète relie 127 nœuds. L’alignement sur les rails permet de maintenir la majeure partie du trafic collectif sur des chemins courts et prévisibles. Ce système fonctionne de manière optimale lorsque le planificateur de tâches connaît la topologie du réseau.
InfiniBand vs RoCE
L'infrastructure évolutive utilise généralement l'un des deux protocoles de transport RDMA suivants :
- InfiniBand est spécialement conçu pour le calcul haute performance. Il intègre des fonctions de contrôle de congestion et de routage adaptatif, et constitue depuis longtemps la solution par défaut dans les conceptions de référence de NVIDIA.
- RoCE (RDMA sur Ethernet convergé) exécute le protocole RDMA sur des commutateurs Ethernet. Meta utilise le protocole RoCE à grande échelle. L'entreprise dispose de architectures partagées pour des clusters comptant jusqu'à 32 000 GPU, et une variante à grande échelle de Llama 3 a été entraînée sur 16 000 GPU au sein d'un cluster RoCE de 24 000 GPU.
Le RoCE nécessite un réglage minutieux. Meta a indiqué utiliser un contrôle de flux prioritaire (PFC) basé sur le DSCP avec une seule file d’attente “ sans perte ”. L’entreprise a d’abord testé le contrôle de congestion DCQCN, puis a intégré la gestion de la congestion au sein même de la bibliothèque collective. Dans ce contexte, le terme « sans perte » désigne un objectif de conception qui dépend de la configuration de bout en bout, et non une garantie que les paquets ne seront jamais perdus.
La technologie Ethernet dédiée à l'IA est encore en cours de développement. Le consortium Ultra Ethernet a publié le 11 juin 2025 sa spécification UEC 1.0, qui couvre l'ensemble de la pile, des cartes réseau et commutateurs aux composants optiques et câbles. Il s'agit d'une nouvelle spécification qui ne remplace pour l'instant aucune des deux options mentionnées ci-dessus.
Du tissu aux liaisons physiques : câbles, composants optiques et connecteurs
C'est à ce stade que le schéma architectural rejoint le chemin de câbles, et c'est là que de nombreux projets d'IA rencontrent des difficultés.
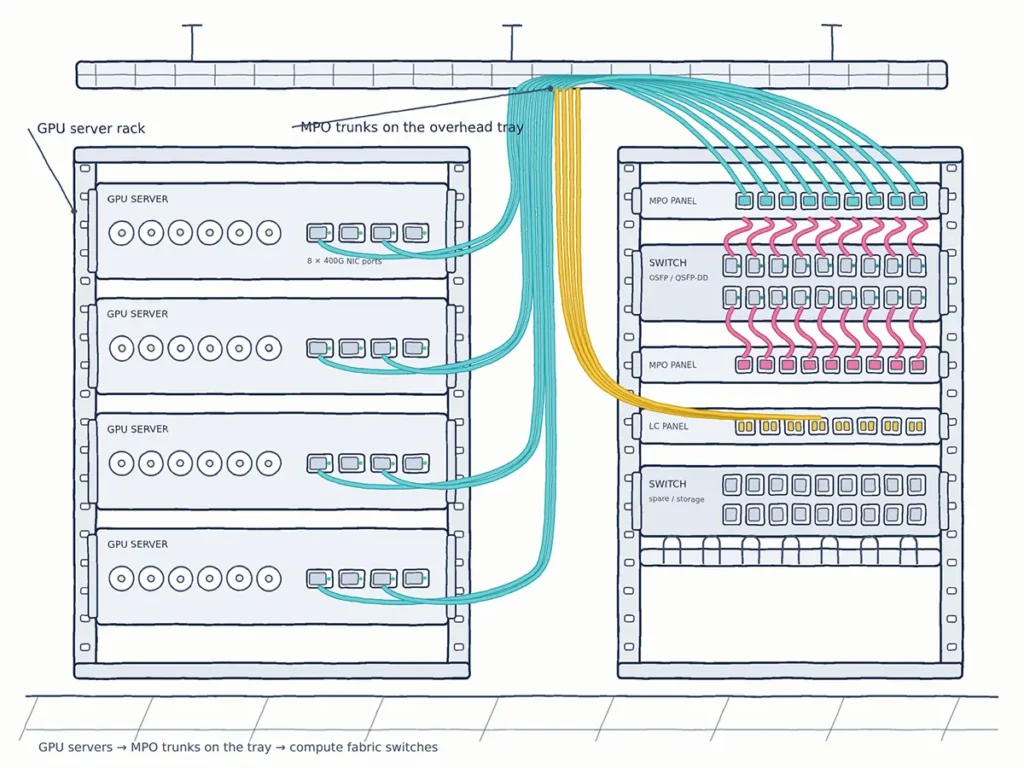
Types de liens. Les clusters de GPU combinent plusieurs types de supports. Les câbles en cuivre passifs (DAC) et actifs (ACC ou AEC) sont utilisés pour des longueurs très courtes à l'intérieur d'un rack ou vers un rack adjacent. Les câbles optiques actifs (AOC) couvrent les liaisons fixes plus longues. Pour les liaisons entre les rangées et les salles, ainsi que pour toute liaison que vous souhaitez reconfigurer ultérieurement, les grappes utilisent des émetteurs-récepteurs optiques enfichables avec un câblage fibre optique structuré. Les limites de portée dépendent du produit concerné ; il est donc préférable de vérifier les spécifications de chaque fournisseur plutôt que de se fier à une règle empirique.
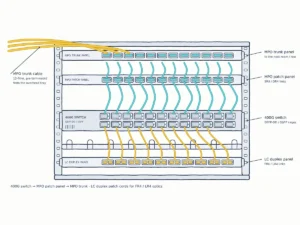
Concrétisons cela. Sur les commutateurs InfiniBand et Ethernet 400G à refroidissement par air de NVIDIA, chaque baie OSFP comporte deux ports de 400 Gb/s. L'émetteur-récepteur double port 800G correspondant contient deux moteurs DR4 et dispose de deux connecteurs monomodes MPO-12/APC, un par port 400G, chacun utilisant huit fibres (quatre pour l'émission, quatre pour la réception). NVIDIA indique une portée maximale de 500 m et précise que sa longueur de câble de 100 m “ suppose la présence de deux panneaux de brassage optiques dans la liaison ”. Côté serveur, chaque port 400G ConnectX-7 nécessite un module optique DR4 correspondant. Il en résulte un grand nombre de liaisons monomodes MPO-12/APC. Pour savoir comment les modules DR4 et autres modules optiques 400G se mappent à la fibre, consultez notre Guide du réseau 400G.

Le véritable défi réside dans l'échelle. Multipliez huit liaisons de calcul par serveur par des centaines de serveurs, ajoutez les liaisons montantes vers le spine, le stockage et les systèmes de gestion, et le nombre de fibres augmente rapidement. Il n’existe pas de chiffre fiable dans le secteur concernant le nombre de “ fibres par GPU ”, car cela dépend de la topologie. Calculez-le à partir de votre conception : nombre de nœuds × nombre de ports par nœud × nombre de fibres par port, plus les liaisons principales, les panneaux de brassage et les fibres de rechange. Les problèmes pratiques sont la densité, l’acheminement des câbles, l’étiquetage et le nettoyage de milliers de faces d’extrémité MPO.
C'est là que la qualité du câblage influe sur les performances du cluster. Les câbles MPO/MTP à faibles pertes laissent une marge dans le budget de perte pour les panneaux de brassage. Une polarité constante et un brochage correct permettent d'éviter que certaines liaisons restent tout simplement inactives. Des connecteurs propres et contrôlés réduisent les erreurs de liaison et les fluctuations qui ralentissent les collectifs.
Problèmes courants liés aux réseaux de GPU et comment les détecter à temps
Voici les problèmes que nous rencontrons le plus souvent, en partant de la couche physique :
- Des liens qui clignotent ou dont le compteur d'erreurs augmente. Commencez par la couche physique. Inspectez et nettoyez les deux faces d'extrémité, réinsérez le module optique, puis vérifiez le cheminement de la fibre et la polarité. Ne remettez pas les compteurs à zéro avant de les avoir notés. Une augmentation des erreurs corrigées par le FEC ne signifie pas toujours que le connecteur est encrassé, mais c'est la cause la moins coûteuse à écarter.
- Certaines voies ou certains ports restent hors service. Vérifiez le mode du port et la configuration du connecteur, l'accouplement avec ou sans broches, la méthode de polarité et l'incompatibilité APC/UPC.
- Débit inférieur aux prévisions, sans cause apparente. Examinez l'équilibre du trafic entre les liaisons « rails » et « spine », les paramètres de congestion et le placement des tâches. Sur les forums, des ingénieurs signalent que les tests de formation enregistrent une baisse du débit sans qu'aucune erreur ne soit détectée du côté du ML. Il convient de considérer ces informations comme des anecdotes plutôt que comme des statistiques, mais elles montrent qu'il vaut la peine de vérifier d'abord le réseau.
- Problèmes au niveau du serveur. Le guide de dépannage des clusters d'AMD recommande de vérifier “ l'état de la liaison PCIe sur tous les périphériques situés sur le chemin de transmission des paquets entre le processeur et la carte réseau ”. Une liaison PCIe défaillante peut en effet ressembler à s'y méprendre à un problème réseau.
- Blocages difficiles à reproduire. Le traçage au niveau collectif s'avère utile. L'équipe Llama 3 de Meta a utilisé l'enregistrement des flights NCCL pour recueillir des métadonnées collectives et déterminer à quel moment les tâches se bloquaient.
Avant la mise en service, Testez la perte d'insertion sur chaque liaison, vérifiez la polarité, étiquetez les deux extrémités de chaque câble et enregistrez les valeurs de référence des compteurs d'erreurs. Le dépannage ultérieur s'appuiera sur ces valeurs de référence.
Connectivité passive pour les clusters de GPU proposés par YingFeng
La réussite ou l'échec des clusters d'IA repose sur des milliers de petites connexions répétitives. Fort de plus de 25 ans d'expérience dans la fabrication de fibres optiques, YingFeng produit les composants passifs de ces liaisons :
- Câbles de raccordement et câbles collectifs MPO/MTP disponibles en versions à 8, 12, 16 et 24 fibres, y compris des versions à faibles pertes, fabriquées en salle blanche.
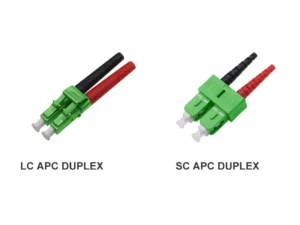
- Cordons de raccordement LC et autres cordons duplex pour le stockage, la gestion et les liaisons de type FR4.
- Kits de connecteurs et composants pour les assembleurs qui réalisent eux-mêmes le câblage de leurs cabines IA, avec des outils sur mesure disponibles.
Indiquez-nous la taille de votre cluster et la liste des émetteurs-récepteurs, et nous vous aiderons à établir une nomenclature adaptée pour vos câbles de raccordement. Nous proposons des services OEM/ODM et fournissons des échantillons sur demande. Consultez également notre solutions de fibre optique pour centres de données.
FAQ
Qu'est-ce que la mise en réseau par GPU ?
Le réseau GPU désigne l'interconnexion qui permet aux GPU d'échanger des données, tant au sein d'un serveur (NVLink/NVSwitch) qu'entre serveurs (InfiniBand ou Ethernet/RoCE). Dans le cadre de l'entraînement en IA, il prend en charge les opérations collectives qui assurent la synchronisation de l'ensemble des GPU.
Quelle est la différence entre « scale-up » et « scale-out » ?
L'évolutivité verticale (scale-up) relie les GPU au sein d'un serveur ou d'un domaine à l'échelle d'un rack avec une bande passante très élevée, par exemple 900 Go/s par GPU avec la technologie Hopper NVLink. L'évolutivité horizontale (scale-out) relie de nombreux serveurs via une structure réseau, généralement à un débit de 400 à 800 Gb/s par carte réseau.
Quel est le meilleur choix pour les clusters de GPU : InfiniBand ou Ethernet ?
Ces deux technologies sont utilisées à grande échelle. InfiniBand intègre un mécanisme de contrôle de la congestion bien éprouvé. La technologie RoCE sur Ethernet a fait ses preuves à grande échelle chez des opérateurs tels que Meta, mais nécessite un réglage minutieux. Le choix approprié dépend de l’échelle du déploiement, des compétences existantes et de la stratégie du fournisseur.
Qu'est-ce qu'un réseau optimisé pour le rail ?
Dans un réseau optimisé par « rail », les GPU portant le même numéro sur chaque serveur se connectent au même commutateur « leaf ». Dans le SuperPOD DGX H100 de NVIDIA, cela permet de maintenir le trafic au sein d’une unité de 32 nœuds à un saut de distance sur chaque « rail ».
Quels câbles relient les serveurs GPU aux commutateurs ?
Cela dépend de la distance. Les câbles DAC en cuivre ou les câbles en cuivre actifs sont utilisés pour les liaisons très courtes au sein d'un rack. Pour les liaisons plus longues, les clusters utilisent des émetteurs-récepteurs optiques, souvent de type 400G DR4 avec des cordons de raccordement monomodes MPO-12/APC, ou des câbles optiques actifs.
Références externes
- Architecture de référence NVIDIA DGX SuperPOD H100, structures réseau : https://docs.nvidia.com/dgx-superpod/reference-architecture-scalable-infrastructure-h100/latest/network-fabrics.html
- Opérations collectives NVIDIA NCCL : https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html
- Meta, “ RDMA sur Ethernet pour l'entraînement distribué de l'IA à l'échelle de Meta ” (SIGCOMM 2024)
- “ The Llama 3 Herd of Models ”, arXiv:2407.21783
- Consortium Ultra Ethernet, annonce de la spécification 1.0 (11 juin 2025)