
ÍNDICE
La red de GPU es el conjunto de enlaces, conmutadores y protocolos que permiten a las GPU intercambiar datos entre sí, tanto dentro de un servidor como a través de un clúster. En el entrenamiento de IA, esta red es tan importante como las propias GPU. Las GPU deben sincronizar sus resultados muchas veces durante cada paso del entrenamiento, por lo que un enlace lento o defectuoso puede retrasar todo el proceso.
Analizaremos las redes de GPU desde la arquitectura hasta la capa física: cómo se comunican las GPU dentro de un servidor, cómo se conectan entre sí los clústeres y qué cables y conexiones de fibra transportan el tráfico.
Por qué los clústeres de GPU necesitan una red diferente
Una red tradicional de centro de datos gestiona numerosos flujos independientes: solicitudes web, consultas a bases de datos y transferencias de archivos. Un clúster de entrenamiento de IA se comporta de manera diferente.
Cuando se entrena un modelo en varias GPU, cada una de ellas realiza una parte del trabajo y, a continuación, comparte los resultados con las demás a través de operaciones colectivas. La biblioteca NCCL de NVIDIA, por ejemplo, ofrece las funciones AllReduce, AllGather, ReduceScatter y AlltoAll. En una operación AllReduce, los datos de cada GPU se combinan (por ejemplo, se suman) y el resultado se devuelve a todas ellas. Según Meta, esta sincronización “requiere la transferencia de grandes cantidades de datos entre las GPU en milisegundos, lo que se repite a lo largo de múltiples iteraciones hasta que el modelo converge”.”
De ello se derivan dos consecuencias:
- El eslabón más lento marca el ritmo. Un trabajo colectivo solo finaliza cuando todos los participantes han terminado. Una ruta congestionada o un enlace que se reinicia constantemente ralentiza todas las GPU del trabajo.
- La latencia predecible es tan importante como el ancho de banda bruto. Una red con un rendimiento medio elevado, pero con retrasos impredecibles, sigue desperdiciando tiempo de la GPU.
Los fallos también cuentan. Durante un periodo de 54 días de preentrenamiento de Llama 3 405B, Meta registró 466 interrupciones en el funcionamiento. De ellas, 47 fueron planificadas y 419, inesperadas. Las “interrupciones en conmutadores de red o cables” representaron 35 de las interrupciones inesperadas (8,41 TP3T), y las tarjetas de red (NIC), otras 7 (1,71 TP3T). Las GPU defectuosas y la memoria de las GPU fueron causas más importantes, y aun así el equipo logró más de 901 TP3T de tiempo de entrenamiento efectivo. No estamos diciendo que las redes sean el problema principal. Lo que decimos es que, a esta escala, los cables y los conmutadores fallan con suficiente frecuencia como para que haya que tenerlo en cuenta en la planificación.
Escalabilidad vertical frente a escalabilidad horizontal
Las redes de GPU tienen dos capas que a menudo se confunden.
| Ampliación | Escalabilidad horizontal | |
|---|---|---|
| Ámbito de aplicación | GPU dentro de un servidor o de un dominio a escala de rack | GPU en distintos servidores y racks |
| Tecnología típica | NVLink y NVSwitch | InfiniBand o Ethernet (RoCE) |
| Ejemplo de ancho de banda | 900 GB/s por GPU (NVLink, Hopper); 1.800 GB/s (Blackwell) | Hasta 400 Gb/s por tarjeta de red (ConnectX-7); 800 Gb/s (ConnectX-8) |
| Soportes físicos | Pistas de placas de circuito impreso, cables NVLink y placas base | Cables de cobre, cables activos, transceptores ópticos y fibra óptica |
Presta atención a las unidades de medida: las cifras de NVLink se expresan en gigabytes por segundo, mientras que los puertos de red se miden en gigabits por segundo. Las dos capas desempeñan funciones diferentes y no compiten entre sí. La escalabilidad vertical conecta estrechamente las GPU de un nodo o rack. La escalabilidad horizontal permite que miles de esos nodos funcionen como un único clúster.

Las cuatro redes de un centro de datos de IA
Un clúster de IA suele ejecutar varias redes independientes. La arquitectura de referencia DGX SuperPOD de NVIDIA para sistemas H100 define cuatro:
- Estructura informática (back-end). Esto permite el tráfico de GPU a GPU entre nodos. Cada sistema DGX H100 cuenta con ocho adaptadores ConnectX-7 para esta red, con una velocidad de hasta 400 Gb/s cada uno, conectados a través de cuatro puertos OSFP. Esto supone un adaptador de red por cada GPU. Los servidores de entrenamiento Grand Teton de Meta siguen la misma relación 1:1 entre GPU y tarjetas de red.
- Tejido para almacenamiento. Esto introduce datos de entrenamiento y guarda puntos de control. El diseño de SuperPOD establece que la E/S por nodo “debe superar los 40 GBps”.”
- Gestión en banda. Esto conecta los servicios que gestionan el clúster, como la programación de tareas, los repositorios de código y las fuentes de datos. En el DGX H100, el almacenamiento y el tráfico en banda utilizan dos tarjetas ConnectX-7 de doble puerto.
- Gestión fuera de banda. Esta conexión llega al BMC de cada servidor para gestionar la alimentación, la supervisión y la recuperación. En el DGX H100 se trata de un puerto RJ45 de 1 GbE, independiente del resto de redes.
Mantener estas redes separadas permite aislar las averías y garantiza que el tráfico de entrenamiento sea predecible. En cuanto al cableado, esto significa que cada servidor con GPU puede necesitar ocho o más enlaces ópticos de alta velocidad solo para la computación, además de conexiones independientes para el almacenamiento y la gestión.
Diseño de la estructura de red de fondo: topología, vías y transporte sin pérdidas
Diseño optimizado para la espina de la hoja y el carril
La mayoría de las estructuras de back-end de las GPU utilizan una topología «leaf-spine» (Clos). Los clústeres de GPU incorporan una mejora denominada optimización ferroviaria, o alineación de rail. En un servidor con ocho GPU, la GPU 1 se conecta a un conmutador leaf, la GPU 2 a otro, y así sucesivamente. El conjunto de todos los puertos “GPU 1” de un grupo de servidores forma un rail.
En el DGX H100 SuperPOD, cada unidad escalable (SU) de 32 nodos está alineada por “rails”. Tal y como explica NVIDIA, el tráfico en un “rail” «siempre está a un salto de distancia de los otros 31 nodos de una SU», mientras que el tráfico entre «rails» o SUs «atraviesa la capa de columna vertebral». El diseño de referencia completo conecta 127 nodos. La alineación por «rails» mantiene la mayor parte del tráfico colectivo en rutas cortas y predecibles. Funciona mejor cuando el programador de tareas conoce la topología.
InfiniBand frente a RoCE
La estructura escalable suele utilizar uno de los dos protocolos de transporte RDMA:
- InfiniBand Está diseñado específicamente para la computación de alto rendimiento. Incorpora control de congestión y enrutamiento adaptativo, y lleva mucho tiempo siendo la opción predeterminada en los diseños de referencia de NVIDIA.
- RoCE (RDMA sobre Ethernet convergente) ejecuta RDMA en conmutadores Ethernet. Meta ejecuta RoCE a gran escala. Cuenta con diseños compartidos para clústeres de hasta 32 000 GPU, y se entrenó una variante de gran tamaño de Llama 3 en 16 000 GPU en un clúster RoCE de 24 000 GPU.
El RoCE requiere un ajuste minucioso. Meta informó de que utilizaba el control de flujo prioritario (PFC) basado en DSCP con una única cola “sin pérdidas”. Primero probó el control de congestión DCQCN y, posteriormente, trasladó la gestión de la congestión a la propia biblioteca colectiva. En este contexto, «sin pérdidas» es un objetivo de diseño que depende de la configuración de extremo a extremo, no una garantía de que nunca se pierdan paquetes.
El Ethernet para la IA sigue en fase de desarrollo. El Ultra Ethernet Consortium publicó su especificación UEC 1.0 el 11 de junio de 2025, que abarca toda la pila, desde las tarjetas de red y los conmutadores hasta los componentes ópticos y los cables. Se trata de una nueva especificación que, por el momento, no sustituye a ninguna de las opciones anteriores.
De la estructura a los enlaces físicos: cables, componentes ópticos y conectores
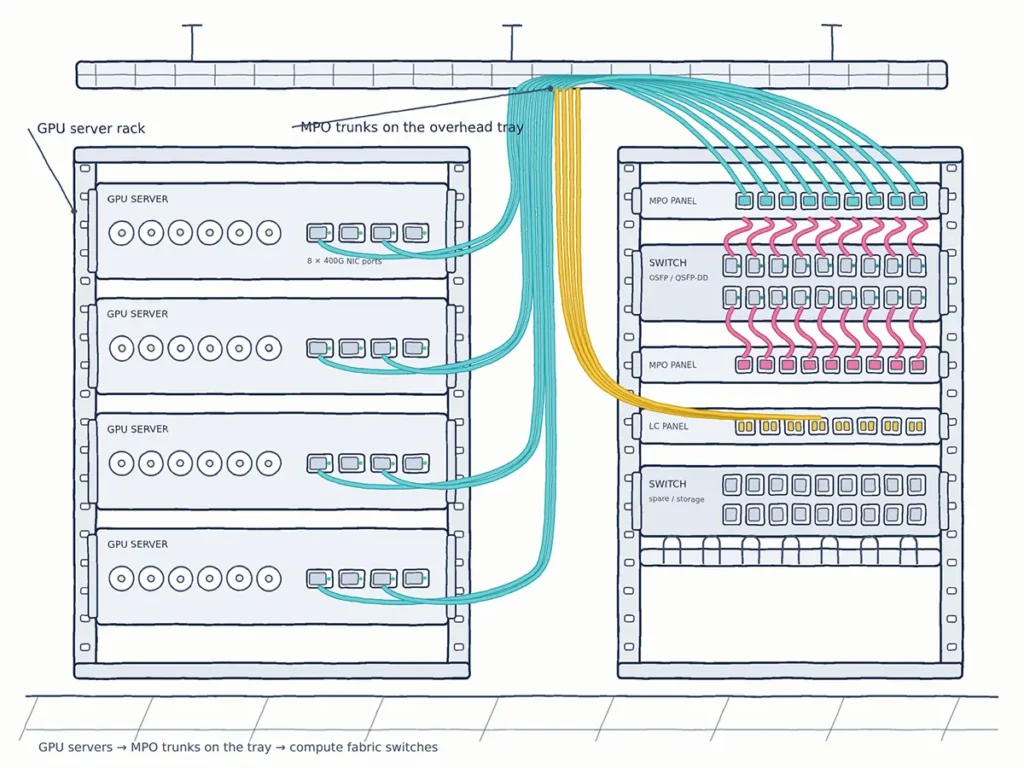
Aquí es donde el diagrama de arquitectura se une a la bandeja de cables, y donde vemos que muchos proyectos de IA se topan con problemas.
Tipos de enlaces. Los clústeres de GPU combinan varios tipos de medios. Los cables de cobre pasivos (DAC) y activos (ACC o AEC) se utilizan para tramos muy cortos dentro de un rack o hacia un rack adyacente. Los cables ópticos activos (AOC) cubren tramos fijos más largos. Para las conexiones entre filas y salas, así como para cualquier conexión que se desee reconfigurar posteriormente, los clústeres utilizan transceptores ópticos enchufables con cableado de fibra estructurado. Los límites de alcance dependen del producto concreto, por lo que conviene consultar las especificaciones de cada fabricante en lugar de basarse en una regla general.
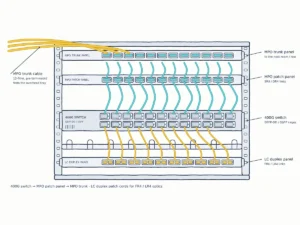
Veamos un ejemplo concreto. En los conmutadores InfiniBand y Ethernet de 400G refrigerados por aire de NVIDIA, cada ranura OSFP alberga dos puertos de 400 Gb/s. El transceptor de doble puerto de 800G correspondiente contiene dos motores DR4 y cuenta con dos conectores monomodo MPO-12/APC, uno por cada puerto de 400G, cada uno de los cuales utiliza ocho fibras (cuatro de transmisión y cuatro de recepción). NVIDIA indica un alcance máximo de 500 m y señala que su longitud de cable de 100 m “supone la presencia de dos paneles de conexión óptica en el enlace”. Por el lado del servidor, cada puerto ConnectX-7 de 400G admite un módulo óptico DR4 compatible. El resultado es un gran número de enlaces monomodo MPO-12/APC. Para saber cómo se corresponden los módulos ópticos DR4 y otros de 400G con la fibra, consulta nuestro Guía de redes de 400G.

La escala es el verdadero reto. Si multiplicamos ocho enlaces de cálculo por servidor por cientos de servidores, y añadimos los enlaces ascendentes a la red central, el almacenamiento y la gestión, el número de fibras aumenta rápidamente. No existe una cifra fiable en el sector para la “fibra por GPU”, ya que depende de la topología. Cálcalo a partir de tu diseño: nodos × puertos por nodo × fibras por puerto, más troncales, paneles de conexión y repuestos. Los problemas prácticos son la densidad, el tendido de los cables, el etiquetado y mantener limpias miles de caras terminales MPO.
Aquí es donde la calidad del cableado se traduce en el rendimiento del clúster. Los cables MPO/MTP de baja pérdida dejan margen en el presupuesto de pérdidas para los paneles de conexiones. Una polaridad uniforme y una disposición correcta de los pines evitan que los enlaces simplemente permanezcan inactivos. Los conectores limpios e inspeccionados reducen los errores de enlace y las oscilaciones que ralentizan los clústeres.
Problemas habituales en las redes de GPU y cómo detectarlos a tiempo
Estos son los problemas que observamos con mayor frecuencia, empezando por la capa física y siguiendo hacia arriba:
- Enlaces que parpadean o muestran contadores de errores que van aumentando. Empieza por la capa física. Inspecciona y limpia ambas caras del conector, vuelve a colocar el módulo óptico y comprueba el recorrido de la fibra y la polaridad. No pongas a cero los contadores hasta que los hayas registrado. El aumento de los errores corregidos por FEC no siempre significa que el conector esté sucio, pero es la causa más económica que se puede descartar.
- Algunos carriles o puertos permanecen cerrados. Comprueba el modo del puerto y la configuración de la conexión, el acoplamiento con o sin fijación de pines, el método de polaridad y la falta de coincidencia entre APC y UPC.
- El rendimiento es inferior al esperado, sin que se aprecie ningún fallo evidente. Fíjate en el equilibrio del tráfico entre los enlaces «rails» y «spine», los parámetros de congestión y la asignación de tareas. Los ingenieros que participan en los foros informan de que, en las ejecuciones de entrenamiento, se pierde rendimiento sin que se produzcan errores por parte del modelo de aprendizaje automático. Aunque hay que tomarlas como anécdotas más que como estadísticas, estas observaciones indican que merece la pena comprobar primero la red.
- Problemas en el servidor. La guía de resolución de problemas de clústeres de AMD recomienda comprobar “el estado del enlace PCIe en todos los dispositivos de la ruta de datos de paquetes entre la CPU y la tarjeta de red”. Un enlace PCIe con rendimiento reducido puede parecer exactamente igual que un problema de red.
- Bloqueos difíciles de reproducir. El seguimiento a nivel colectivo resulta útil. El equipo de Llama 3 de Meta utilizó el registro de vuelos de NCCL para recopilar metadatos colectivos y los momentos en los que los trabajos se atascaban.
Antes de la puesta en marcha, Comprueba la pérdida de inserción en cada enlace, verifica la polaridad, etiqueta ambos extremos de cada cable y anota los contadores de errores de referencia. La resolución de problemas en el futuro dependerá de esa referencia.
Conectividad pasiva para clústeres de GPU de YingFeng
El éxito o el fracaso de los clústeres de IA depende de miles de pequeñas conexiones repetitivas. YingFeng cuenta con más de 25 años de experiencia en la fabricación de fibra óptica y produce los componentes pasivos de esos enlaces:
- Cables de conexión y troncales MPO/MTP en versiones de 8, 12, 16 y 24 fibras, incluidas las de baja pérdida, fabricadas en una sala limpia.
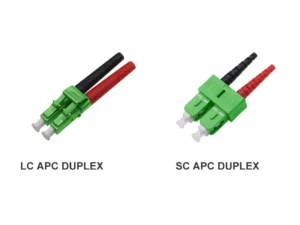
- Cables de conexión LC y otros cables de conexión dúplex para el almacenamiento, la gestión y los enlaces de tipo FR4.
- Kits y componentes de conectores Para montadores que fabrican su propio cableado para IA, con herramientas a medida disponibles.
Indícanos el tamaño de tu clúster y la lista de transceptores, y te ayudaremos a elaborar una lista de materiales (BOM) para los cables de conexión adecuados. Ofrecemos servicios OEM/ODM y proporcionamos muestras previa solicitud. Consulta también nuestra soluciones de fibra óptica para centros de datos.
PREGUNTAS FRECUENTES
¿Qué es la red basada en GPU?
Las redes de GPU son la interconexión que permite a las GPU intercambiar datos, tanto dentro de un servidor (NVLink/NVSwitch) como entre servidores (InfiniBand o Ethernet/RoCE). En el entrenamiento de IA, se encargan de las operaciones colectivas que mantienen sincronizadas todas las GPU.
¿Cuál es la diferencia entre «scale-up» y «scale-out»?
La escalabilidad vertical conecta las GPU dentro de un servidor o un dominio a escala de rack con un ancho de banda muy elevado, como por ejemplo 900 GB/s por GPU con Hopper NVLink. La escalabilidad horizontal conecta numerosos servidores a través de una estructura de red, normalmente a una velocidad de entre 400 y 800 Gb/s por adaptador de red.
¿Qué es mejor para los clústeres de GPU, InfiniBand o Ethernet?
Ambas tecnologías se utilizan a gran escala. InfiniBand ofrece un control de congestión integrado y consolidado. RoCE sobre Ethernet ha demostrado su eficacia a gran escala en operadores como Meta, pero requiere un ajuste minucioso. La elección adecuada depende de la escala, las competencias existentes y la estrategia del proveedor.
¿Qué es una red optimizada para el transporte ferroviario?
En una red optimizada por rail, las GPU con el mismo número de cada servidor se conectan al mismo conmutador leaf. En el DGX H100 SuperPOD de NVIDIA, esto hace que el tráfico dentro de una unidad de 32 nodos se mantenga a un salto de distancia en cada rail.
¿Qué cables conectan los servidores de GPU a los conmutadores?
Depende de la distancia. Los cables DAC de cobre o los cables de cobre activos se utilizan para tramos muy cortos dentro del rack. Para enlaces más largos, los clústeres utilizan transceptores ópticos, a menudo de 400G DR4 con cables de conexión monomodo MPO-12/APC, o cables ópticos activos.
Referencias externas
- Arquitectura de referencia del NVIDIA DGX SuperPOD H100, estructuras de red: https://docs.nvidia.com/dgx-superpod/reference-architecture-scalable-infrastructure-h100/latest/network-fabrics.html
- Operaciones colectivas de NVIDIA NCCL: https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html
- Meta, “RDMA sobre Ethernet para el entrenamiento distribuido de IA a escala Meta” (SIGCOMM 2024)
- “The Llama 3 Herd of Models”, arXiv:2407.21783
- Consorcio Ultra Ethernet, anuncio de la especificación 1.0 (11 de junio de 2025)