
جدول المحتويات
شبكة وحدات معالجة الرسومات (GPU) هي مجموعة من الوصلات والمحولات والبروتوكولات التي تتيح لوحدات معالجة الرسومات تبادل البيانات فيما بينها، سواء داخل الخادم أو عبر المجموعة. وفي تدريب الذكاء الاصطناعي، تكتسب هذه الشبكة أهمية لا تقل عن أهمية وحدات معالجة الرسومات نفسها. حيث يتعين على وحدات معالجة الرسومات مزامنة نتائجها عدة مرات خلال كل خطوة من خطوات التدريب، لذا فإن أي وصلة بطيئة أو معطلة يمكن أن تؤدي إلى تعطيل المهمة بأكملها.
سنتناول موضوع شبكات وحدات معالجة الرسومات (GPU) بدءًا من البنية وصولاً إلى الطبقة المادية: كيف تتواصل وحدات معالجة الرسومات داخل الخادم، وكيف يتم توصيل المجموعات معًا، وما هي الكابلات ووصلات الألياف الضوئية التي تنقل حركة البيانات.
لماذا تحتاج مجموعات وحدات معالجة الرسومات (GPU) إلى شبكة مختلفة
تنقل شبكة مركز البيانات التقليدية العديد من التدفقات المستقلة: طلبات الويب، واستعلامات قواعد البيانات، وعمليات نقل الملفات. أما مجموعة تدريب الذكاء الاصطناعي فتعمل بطريقة مختلفة.
عندما يتم تدريب نموذج ما باستخدام العديد من وحدات معالجة الرسومات (GPU)، تقوم كل وحدة من هذه الوحدات بحساب جزء من العمل، ثم تشارك النتائج مع الوحدات الأخرى من خلال العمليات الجماعية. على سبيل المثال، توفر مكتبة NCCL من NVIDIA وظائف AllReduce وAllGather وReduceScatter وAlltoAll. في عملية AllReduce، يتم دمج البيانات الواردة من كل وحدة معالجة رسومات (GPU) (مثل جمعها)، ثم يتم إرجاع النتيجة إلى جميع هذه الوحدات. وبحسب تعبير Meta، فإن هذه المزامنة “تتطلب نقل كميات كبيرة من البيانات بين وحدات معالجة الرسومات (GPU) في غضون أجزاء من الألف من الثانية، ويتكرر ذلك عبر عدة تكرارات حتى يتقارب النموذج”.”
وينتج عن ذلك أمران:
- الحلقة الأبطأ هي التي تحدد السرعة. لا تنتهي المهمة الجماعية إلا عندما ينتهي كل مشارك منها. فأي مسار مزدحم أو رابط يستمر في إعادة التدريب يؤدي إلى إبطاء كل وحدة معالجة رسومات (GPU) في المهمة.
- يُعد زمن الوصول المتوقع عاملاً مهمًا بقدر أهمية النطاق الترددي الخام. إن الشبكة التي تتمتع بمتوسط معدل نقل بيانات مرتفع، ولكنها تعاني من تأخيرات غير متوقعة، لا تزال تهدر وقت وحدة معالجة الرسومات (GPU).
الفشل مهم أيضًا. خلال فترة 54 يومًا من التدريب المسبق لنموذج Llama 3 405B، سجلت شركة Meta 466 حالة انقطاع في أداء المهام. ومن بين هذه الحالات، كانت 47 حالة مخططًا لها و419 حالة غير متوقعة. شكلت “محولات الشبكة/الكابلات” 35 من حالات الانقطاع غير المتوقعة (8.4%)، بينما شكلت بطاقات شبكة (NICs) 7 حالات أخرى (1.7%). كانت وحدات معالجة الرسومات (GPU) وذاكرة GPU المعيبة من الأسباب الأكبر، ومع ذلك حقق الفريق أكثر من 90% من وقت التدريب الفعلي. نحن لا نقول إن الشبكات هي المشكلة الرئيسية. بل نقول إنه على هذا النطاق، تتعطل الكابلات والمحولات بشكل متكرر بما يكفي بحيث يتعين عليك التخطيط لمواجهة ذلك.
التوسع الرأسي مقابل التوسع الأفقي
تتألف شبكات وحدة معالجة الرسومات (GPU) من طبقتين غالبًا ما يتم الخلط بينهما.
| توسيع النطاق | التوسع الأفقي | |
|---|---|---|
| نطاق | وحدات معالجة الرسومات (GPU) داخل خادم أو نطاق على مستوى الرف | وحدات معالجة الرسومات (GPU) في خوادم ورفوف مختلفة |
| التكنولوجيا النموذجية | NVLink و NVSwitch | إنفيني باند أو إيثرنت (RoCE) |
| مثال على عرض النطاق الترددي | 900 جيجابايت في الثانية لكل وحدة معالجة رسومات (NVLink، Hopper)؛ 1,800 جيجابايت في الثانية (Blackwell) | ما يصل إلى 400 جيجابت في الثانية لكل بطاقة شبكة (ConnectX-7)؛ 800 جيجابت في الثانية (ConnectX-8) |
| الوسائط المادية | مسارات اللوحة، وكابلات NVLink، واللوحات الخلفية | الكابلات النحاسية، والكابلات النشطة، وأجهزة الإرسال والاستقبال الضوئية، والألياف الضوئية |
انتبه إلى وحدات القياس: تُقاس أرقام NVLink بالجيجابايت في الثانية، بينما تُقاس منافذ الشبكة بالجيجابت في الثانية. تؤدي الطبقتان مهام مختلفة ولا تتنافسان. تعمل تقنية «التوسع الرأسي» (Scale-up) على ربط وحدات معالجة الرسومات (GPUs) في عقدة واحدة أو رف واحد بشكل وثيق. أما تقنية «التوسع الأفقي» (Scale-out) فتسمح لآلاف من هذه العقد بالعمل ككتلة واحدة.

الشبكات الأربع داخل مركز بيانات الذكاء الاصطناعي
عادةً ما تشغّل مجموعة أنظمة الذكاء الاصطناعي عدة شبكات منفصلة. وتحدد البنية المرجعية DGX SuperPOD من NVIDIA الخاصة بأنظمة H100 أربع شبكات هي:
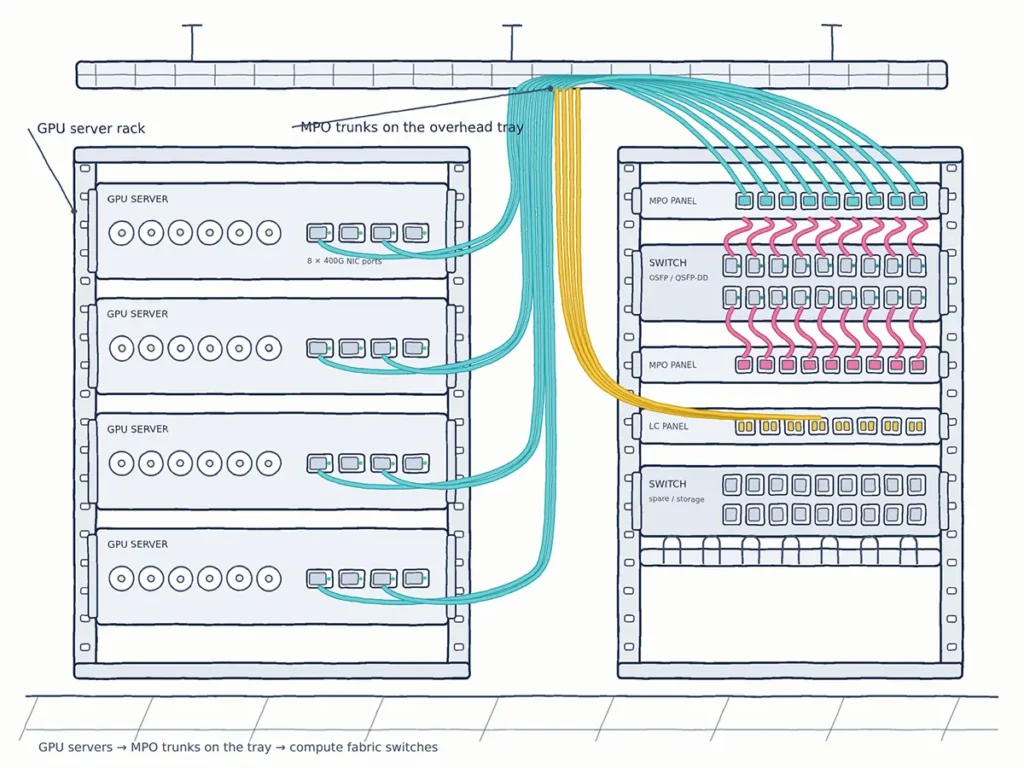
- بنية الحوسبة (الخلفية). وهذا ينقل حركة المرور بين وحدات معالجة الرسومات (GPU) عبر العقد. ويحتوي كل نظام DGX H100 على ثمانية محولات ConnectX-7 لهذه الشبكة، تصل سرعة كل منها إلى 400 جيجابت في الثانية، ويتم توصيلها عبر أربعة منافذ OSFP. وهذا يعني وجود محول شبكة واحد لكل وحدة معالجة رسومات (GPU). وتتبع خوادم التدريب «Grand Teton» التابعة لشركة «Meta» نفس التناظر بنسبة 1:1 بين وحدات معالجة الرسومات (GPUs) وبطاقات الشبكة (NICs).
- نسيج التخزين. يؤدي ذلك إلى تغذية البيانات التدريبية وحفظ نقاط التحقق. وينص تصميم SuperPOD على أن معدل الإدخال/الإخراج لكل عقدة “يجب أن يتجاوز 40 جيجابايت في الثانية”.”
- الإدارة داخل النطاق. وهذا يربط بين الخدمات التي تُشغّل المجموعة، مثل جدولة المهام ومستودعات الكود ومصادر البيانات. وفي نظام DGX H100، يستخدم التخزين وحركة المرور داخل النطاق بطاقتين من طراز ConnectX-7 ثنائيتي المنافذ.
- الإدارة خارج النطاق. يصل هذا إلى وحدة إدارة النظام (BMC) لكل خادم من أجل إدارة الطاقة والمراقبة والاستعادة. وفي خادم DGX H100، يتخذ هذا المنفذ شكل منفذ RJ45 بسرعة 1 جيجابت في الثانية، ويتم فصله عن الشبكات الأخرى.
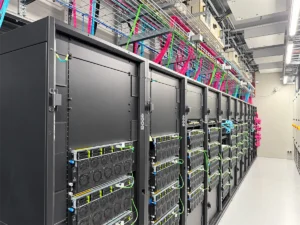
إن الفصل بين هذه الشبكات يساعد على عزل الأعطال ويحافظ على إمكانية التنبؤ بحركة مرور البيانات الخاصة بالتدريب. وفيما يتعلق بالتوصيلات الكبلية، فهذا يعني أن كل خادم مزود بوحدة معالجة رسومات (GPU) قد يحتاج إلى ثمانية وصلات ضوئية عالية السرعة أو أكثر مخصصة للحوسبة وحدها، بالإضافة إلى وصلات منفصلة للتخزين والإدارة.
تصميم بنية الشبكة الخلفية: الطوبولوجيا، والرايلز، والنقل بدون فقدان بيانات
تصميم مُحسَّن خصيصًا للعمود الفقري للأوراق والسكك الحديدية
تستخدم معظم شبكات الوراء الخاصة بوحدات معالجة الرسومات (GPU) طوبولوجيا «الورقة والعمود» (Clos). وتضيف مجموعات وحدات معالجة الرسومات (GPU) تحسينًا يُسمى تحسين السكك الحديدية, ، أو مسار “رايل”. في خادم مزود بثماني وحدات معالجة رسومية (GPU)، تتصل وحدة GPU 1 بمحول طرفي واحد، ووحدة GPU 2 بمحول طرفي آخر، وهكذا دواليك. وتشكل مجموعة جميع منافذ «GPU 1» عبر مجموعة من الخوادم ما يُعرف بـ«رايل».
في نظام DGX H100 SuperPOD، يتم تنظيم كل وحدة قابلة للتوسعة (SU) المكونة من 32 عقدة وفقًا لنظام المسارات. وكما توضح NVIDIA، فإن حركة البيانات على المسار “تكون دائمًا على بعد قفزة واحدة من العقد الـ31 الأخرى في الوحدة القابلة للتوسعة”، في حين أن حركة البيانات بين المسارات أو الوحدات القابلة للتوسعة “تتجاوز طبقة العمود الفقري”. يربط التصميم المرجعي الكامل 127 عقدة. ويحافظ محاذاة المسارات على بقاء معظم حركة المرور الجماعية في مسارات قصيرة ويمكن التنبؤ بها. وتعمل هذه الميزة بشكل أفضل عندما يكون برنامج جدولة المهام على دراية بالبنية الشبكية.
InfiniBand مقابل RoCE
عادةً ما يعمل نسيج التوسع الأفقي بإحدى طريقتي نقل RDMA التاليتين:
- إنفيني باند وقد صُمم خصيصًا للحوسبة عالية الأداء. ويتميز بنظام مدمج للتحكم في الازدحام والتوجيه التكيفي، وقد ظل لفترة طويلة الخيار الافتراضي في التصاميم المرجعية لشركة NVIDIA.
- RoCE (RDMA عبر شبكة إيثرنت المتكاملة) تعمل تقنية RDMA على محولات إيثرنت. وتقوم شركة Meta بتشغيل تقنية RoCE على نطاق واسع. ولديها تصاميم مشتركة لمجموعات تصل إلى 32,000 وحدة معالجة رسومات (GPU)، كما تم تدريب نسخة كبيرة من نموذج Llama 3 على 16,000 وحدة معالجة رسومات (GPU) ضمن مجموعة RoCE تضم 24,000 وحدة معالجة رسومات (GPU).
يتطلب RoCE ضبطًا دقيقًا. أفادت شركة Meta أنها تستخدم التحكم في تدفق الأولوية (PFC) القائم على DSCP مع قائمة انتظار واحدة خالية من الفقدان. وقد جربت أولاً التحكم في الازدحام باستخدام DCQCN، ثم نقلت إدارة الازدحام إلى المكتبة الجماعية نفسها. ويُقصد بـ“خالية من الفقدان” في هذا السياق هدفًا تصميميًا يعتمد على التكوين من طرف إلى طرف، وليس ضمانًا بعدم فقدان الحزم مطلقًا.
لا تزال تقنية إيثرنت المخصصة للذكاء الاصطناعي في مرحلة التطوير. وقد أصدر اتحاد «ألترا إيثرنت» (Ultra Ethernet Consortium) مواصفاته UEC 1.0 في 11 يونيو 2025، والتي تغطي المجموعة الكاملة من بطاقات الشبكة والمحولات وصولاً إلى المكونات الضوئية والكابلات. وهي مواصفة جديدة، ولم تحل بعد محل أي من الخيارين المذكورين أعلاه.
من النسيج إلى الوصلات المادية: الكابلات والألياف الضوئية والموصلات
هذا هو المكان الذي يلتقي فيه مخطط البنية مع مسار الكابلات، وحيث نرى العديد من أنظمة الذكاء الاصطناعي تواجه مشاكل.
أنواع الروابط. تجمع مجموعات وحدات معالجة الرسومات (GPU) بين عدة أنواع من الوسائط. تُستخدم الكابلات النحاسية السلبية (DAC) والكابلات النحاسية النشطة (ACC أو AEC) للمسافات القصيرة جدًّا داخل الحامل أو إلى حامل مجاور. أما الكابلات البصرية النشطة (AOC) فتغطي المسافات الثابتة الأطول. وبالنسبة للوصلات بين الصفوف والغرف، ولأي وصلة ترغب في إعادة توصيلها لاحقًا، تستخدم المجموعات أجهزة إرسال واستقبال ضوئية قابلة للتوصيل مع كابلات ألياف منظمة. تعتمد حدود المدى على المنتج المحدد، لذا تحقق من مواصفات كل مورد بدلاً من الاعتماد على قاعدة عامة.
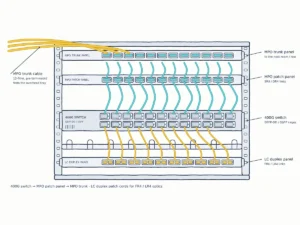
دعونا نوضح ذلك بشكل ملموس. في محولات NVIDIA من نوع InfiniBand وEthernet التي تعمل بتردد 400G والمبردة بالهواء، يحتوي كل حامل OSFP على منفذين بسرعة 400 جيجابت في الثانية. يحتوي جهاز الإرسال والاستقبال المزدوج المنفذ 800G المطابق على محركين من نوع DR4 وموصلين أحاديي النمط من نوع MPO-12/APC، واحد لكل منفذ 400G، يستخدم كل منهما ثماني ألياف (أربعة للإرسال وأربعة للاستقبال). توفر NVIDIA مدىً أقصى يبلغ 500 متر، وتشير إلى أن طول الكابل البالغ 100 متر “يفترض وجود لوحتي توصيل ضوئيتين في الوصلة”. على جانب الخادم، يستخدم كل منفذ 400G من طراز ConnectX-7 وحدة بصرية DR4 مطابقة. والنتيجة هي وجود عدد كبير من الوصلات أحادية النمط من نوع MPO-12/APC. لمعرفة كيفية توصيل وحدات DR4 وغيرها من الوحدات البصرية 400G بالألياف الضوئية، انظر دليل شبكة 400G.

التحدي الحقيقي يكمن في الحجم. اضرب ثمانية روابط حوسبة لكل خادم في مئات الخوادم، وأضف روابط الاتصال بالشبكة المركزية (spine) ووحدات التخزين وأنظمة الإدارة، وسيرتفع عدد الألياف الضوئية بسرعة. لا توجد أرقام موثوقة في القطاع بشأن “عدد الألياف لكل وحدة معالجة رسومات (GPU)”، لأن ذلك يعتمد على التوبولوجيا. احسبها بناءً على تصميمك: العقد × المنافذ لكل عقدة × الألياف لكل منفذ، بالإضافة إلى الكابلات الرئيسية ولوحات التوصيل وقطع الغيار. وتتمثل المشكلات العملية في الكثافة، وتوجيه الكابلات، ووضع العلامات، والحفاظ على نظافة آلاف الأطراف الطرفية لموصلات MPO.
وهنا تتجلى أهمية جودة الكابلات في أداء المجموعة. فأسلاك MPO/MTP منخفضة الخسارة تتيح هامشًا في ميزانية الخسارة للوحات التوصيل. كما أن الاتساق في القطبية والتوصيل الصحيح للمسامير يمنعان حدوث وصلات تظل معطلة تمامًا. وتقلل الموصلات النظيفة التي خضعت للفحص من أخطاء الوصلات والتقلبات التي تبطئ أداء المجموعات.
المشاكل الشائعة في شبكات وحدات معالجة الرسومات (GPU) وكيفية اكتشافها مبكرًا
فيما يلي المشكلات التي نواجهها في أغلب الأحيان، بدءًا من الطبقة المادية صعودًا:
- الروابط التي تومض أو تظهر أعدادًا متزايدة من الأخطاء. ابدأ من الطبقة المادية. افحص وجهي الطرفين ونظفهما، وأعد تركيب الوحدة البصرية، وتحقق من مسار الألياف وقطبيتها. لا تقم بمسح العدادات قبل تسجيل قيمها. فارتفاع عدد الأخطاء التي تم تصحيحها بواسطة FEC لا يعني دائمًا أن الموصل متسخ، ولكنه السبب الأرخص الذي يمكن استبعاده.
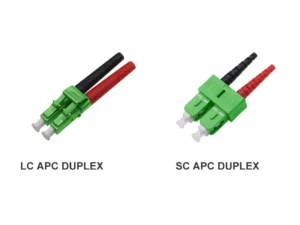
- تظل بعض المسارات أو المنافذ معطلة. تحقق من وضع المنفذ وتكوين التوصيلات الفرعية، والتوصيل المثبت/غير المثبت، وطريقة تحديد القطبية، وعدم تطابق معايير APC/UPC.
- معدل الإنتاجية أقل من المتوقع دون وجود عطل واضح. انظر إلى توازن حركة المرور عبر خطوط السكك الحديدية ووصلات العمود الفقري، وإعدادات الازدحام، وتوزيع المهام. ويشير المهندسون في المنتديات إلى أن عمليات التشغيل التجريبية تسجل انخفاضًا في معدل الإنتاجية دون وجود أخطاء في جانب التعلم الآلي. تعامل مع هذه التقارير على أنها روايات فردية وليس إحصائيات، لكنها تُظهر أن الشبكة تستحق الفحص أولاً.
- مشاكل داخل الخادم. ينصح دليل استكشاف الأعطال وإصلاحها الخاص بمجموعات AMD بالتحقق من “حالة وصلة PCIe على جميع الأجهزة الموجودة في مسار نقل حزم البيانات من وحدة المعالجة المركزية إلى بطاقة الشبكة”. وقد تبدو وصلة PCIe المتدهورة تمامًا كأنها مشكلة في الشبكة.
- حالات توقف النظام التي يصعب إعادة إنتاجها. التتبع على المستوى الجماعي مفيد. استخدم فريق «Llama 3» التابع لشركة «Meta» سجلات NCCL الخاصة بالرحلات الجوية لجمع البيانات الوصفية الجماعية وتوقيت توقف المهام.
قبل بدء التشغيل،, اختبر خسارة الإدخال في كل وصلة، وتحقق من القطبية، وقم بوضع علامات على طرفي كل سلك، وسجل قراءات عدادات الأخطاء المرجعية. ستعتمد عمليات استكشاف الأعطال وإصلاحها في المستقبل على تلك القراءات المرجعية.
الاتصال السلبي لمجموعات وحدات معالجة الرسومات (GPU) من YingFeng
تعتمد كفاءة مجموعات الذكاء الاصطناعي بشكل كامل على آلاف الوصلات الصغيرة المتكررة. تتمتع شركة YingFeng بخبرة تزيد عن 25 عامًا في تصنيع الألياف الضوئية، وتقوم بتصنيع المكونات السلبية لتلك الوصلات:
- كابلات التوصيل والخطوط الرئيسية MPO/MTP بأعداد ألياف تبلغ 8 و12 و16 و24، بما في ذلك الإصدارات منخفضة الخسارة، والتي يتم إنتاجها في غرفة نظيفة.
- LC وأسلاك التوصيل المزدوجة الأخرى للتخزين والإدارة والوصلات من نوع FR4.
- مجموعات الموصلات ومكوناتها للمُجمِّعين الذين يقومون بتصنيع كابلات الذكاء الاصطناعي الخاصة بهم، مع توفر أدوات مخصصة لهذا الغرض.
يرجى إطلاعنا على حجم المجموعة وقائمة أجهزة الإرسال والاستقبال، وسنساعدك في إعداد قائمة مواد (BOM) لكابلات التوصيل المناسبة. تتوفر خدمة التصنيع حسب الطلب (OEM/ODM)، كما يتم توفير العينات عند الطلب. انظر أيضًا إلى حلول الألياف الضوئية لمراكز البيانات.
الأسئلة الشائعة
ما المقصود بشبكات وحدة معالجة الرسومات (GPU)؟
شبكات وحدات معالجة الرسومات (GPU) هي نظام الربط الذي يتيح لوحدات معالجة الرسومات تبادل البيانات، سواء داخل الخادم الواحد (NVLink/NVSwitch) أو بين الخوادم (InfiniBand أو Ethernet/RoCE). وفي تدريب الذكاء الاصطناعي، تتولى هذه الشبكات تنفيذ العمليات الجماعية التي تحافظ على تزامن جميع وحدات معالجة الرسومات.
ما الفرق بين التوسع الرأسي والتوسع الأفقي؟
يعمل التوسع الرأسي (Scale-up) على ربط وحدات معالجة الرسومات (GPUs) داخل خادم واحد أو نطاق على مستوى الرف (rack-scale) بنطاق ترددي عالٍ جدًّا، مثل 900 جيجابايت/ثانية لكل وحدة GPU باستخدام تقنية Hopper NVLink. أما التوسع الأفقي (Scale-out) فيعمل على ربط العديد من الخوادم عبر بنية شبكية، وعادةً ما يتراوح النطاق الترددي بين 400 و800 جيجابت/ثانية لكل محول شبكة.
أيهما أفضل لمجموعات وحدات معالجة الرسومات (GPU): شبكة InfiniBand أم شبكة إيثرنت؟
يُستخدم كلاهما على نطاق واسع. توفر شبكة InfiniBand آلية مدمجة وناضجة للتحكم في الازدحام. أما تقنية RoCE على شبكة إيثرنت، فقد أثبتت فعاليتها على نطاق واسع من قبل مشغلين مثل Meta، لكنها تتطلب ضبطًا دقيقًا. ويعتمد الاختيار الصحيح على الحجم، والمهارات المتوفرة، واستراتيجية المورد.
ما هي الشبكة المُحسَّنة للاستخدام عبر السكك الحديدية؟
في الشبكة المُحسَّنة على أساس المسارات (rails)، تتصل وحدة معالجة الرسومات (GPU) التي تحمل الرقم نفسه في كل خادم بنفس المحول الطرفي (leaf switch). وفي نظام DGX H100 SuperPOD من NVIDIA، يضمن ذلك بقاء حركة المرور داخل وحدة مكونة من 32 عقدة على بعد قفزة واحدة على كل مسار.
ما هي الكابلات التي تربط خوادم وحدة معالجة الرسومات (GPU) بالمحولات؟
يعتمد ذلك على المسافة. تُستخدم محولات DAC النحاسية أو الكابلات النحاسية النشطة في المسافات القصيرة جدًّا داخل الحامل. أما بالنسبة للوصلات الأطول، فتستخدم المجموعات أجهزة إرسال واستقبال ضوئية، غالبًا من نوع 400G DR4 مع كابلات توصيل أحادية النمط من نوع MPO-12/APC، أو كابلات ضوئية نشطة.
المراجع الخارجية
- البنية المرجعية لنظام NVIDIA DGX SuperPOD H100، والبنى الشبكية: https://docs.nvidia.com/dgx-superpod/reference-architecture-scalable-infrastructure-h100/latest/network-fabrics.html
- العمليات الجماعية في NCCL من NVIDIA: https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html
- Meta، “تقنية RDMA عبر شبكة إيثرنت لتدريب الذكاء الاصطناعي الموزع على نطاق Meta” (SIGCOMM 2024)
- “مجموعة نماذج Llama 3”، arXiv:2407.21783
- اتحاد «ألترا إيثرنت»، إعلان المواصفات 1.0 (11 يونيو 2025)