
INHALTSVERZEICHNIS
Sowohl InfiniBand als auch Ethernet können den RDMA-Datenverkehr übertragen, der GPU-Server in einem KI-Cluster miteinander verbindet, und beide werden heute für umfangreiche KI-Workloads eingesetzt. InfiniBand ist eine dedizierte Fabric mit eigenen Switches und einem eigenen Verwaltungsmodell, während Ethernet RDMA über RoCE auf Ethernet-Switches überträgt und in KI-Backend-Netzwerken zunehmend an Bedeutung gewinnt.
Für die Glasfaseranlage ist der Unterschied zwischen InfiniBand und Ethernet geringer, als viele Käufer erwarten. Bei der 400G-Generation von NVIDIA funktionieren die ursprünglichen Transceiver mit beiden Protokollen, und die MPO-12/APC-Stecker, Glasfaserkabel und Patchfelder sind identisch. Allerdings ist nicht jede Artikelnummer dual-protokollfähig. Im Folgenden vergleichen wir die beiden Netzwerkstrukturen und gehen dann Schicht für Schicht von der Netzwerkkarte bis zum Patchfeld durch, um zu zeigen, was sich beim Wechsel ändert und was beibehalten wird.
InfiniBand und Ethernet (RoCE): Was es jeweils ist
InfiniBand ist eine Netzwerkarchitektur, die speziell für Hochleistungsrechner und KI entwickelt wurde. Sie verfügt über eigene Switches, Adapter und Kabel, und die Spezifikation wird von einem einzigen Branchenverband festgelegt. Ethernet ist die universell einsetzbare Netzwerktechnologie, die in fast jedem Rechenzentrum zu finden ist. Für das KI-Training überträgt es denselben RDMA-Datenverkehr über RoCE, was für „RDMA over Converged Ethernet“ steht. RDMA ermöglicht es einem Server, den Speicher eines anderen Servers zu lesen oder zu beschreiben, ohne die CPU dieses Servers einzubeziehen, was die Datenübertragung zwischen GPUs beschleunigt.
Sie werden von zwei verschiedenen Gremien definiert. Die InfiniBand Trade Association (IBTA) definiert und pflegt sowohl die InfiniBand- als auch die RoCE-Spezifikationen. Die physikalische Schicht und die Medienzugriffskontrolle von kabelgebundenem Ethernet werden von der IEEE 802.3-Arbeitsgruppe definiert, die die Ethernet-Standards festlegt. RoCE ist ein branchenüblicher Transportstandard, der den Remote Direct Memory Access (RDMA) in gewöhnlichen Ethernet-Netzwerken der Schichten 2 und 3 ermöglicht; die IBTA veröffentlichte ihre erste Spezifikation im Jahr 2010.
Die Geschwindigkeiten von InfiniBand entwickeln sich in Generationen weiter. Laut der IBTA-Roadmap ist NDR-InfiniBand mit 400 Gb/s bereits heute auf dem Markt, und GDR-Produkte mit 1,6 Tb/s sind für den Zeitraum um das Jahr 2028 geplant.[1]
Ein wichtiger Aspekt: Wir vergleichen das Scale-out-Netzwerk, das Server miteinander verbindet. NVLink ist eine Scale-up-Verbindung für die GPU-zu-GPU-Kommunikation innerhalb eines Rack-Scale-Systems und ergänzt somit InfiniBand oder Ethernet, anstatt eines der beiden zu ersetzen. Unser Leitfaden zum GPU-Netzwerk erläutert, wie die Scale-up- und Scale-out-Ebenen zusammenwirken.

InfiniBand vs. Ethernet auf einen Blick
| InfiniBand | Ethernet mit RoCE | |
|---|---|---|
| Definiert durch | IBTA | IEEE 802.3 für Ethernet; IBTA für den RoCE-Transport |
| RDMA | Muttersprachler | Über RoCE |
| Paketverlust | Entwickelt für verlustfreie I/O-Strukturen | Das verlustfreie Verhalten hängt von den Einstellungen für die Flusssteuerung und die Überlastungssteuerung im gesamten Netzwerk ab. |
| Stoffverwaltung | Ein Subnetz-Manager übernimmt das Routing | Standard-Tools für Ethernet-Switching und den Betrieb |
| Schalter | NVIDIA Quantum InfiniBand-Switches | Mehrere Anbieter; im Jahr 2024 waren Celestica, NVIDIA und Huawei führend im Bereich der KI-Backend-Ethernet-Switches |
| Veröffentlichter Maßstab | Zehntausende Knoten in einem Subnetz (IBTA) | RoCE-Cluster-Designs für bis zu 32.000 GPUs (Meta) |
| Netzwerkkarten | ConnectX-7 unterstützt beide Protokolle | ConnectX-7 unterstützt beide Protokolle |
| Optik und Glasfaser | MPO-12/APC, Singlemode oder Multimode | Gleiche Steckverbinder und Glasfaser wie bei der 400G-Generation |
Latenz und Leistung: Warum die Zahlen voneinander abweichen
InfiniBand wird oft wegen seiner geringen Latenz gewählt, doch Behauptungen, dass eine Fabric eine geringere Latenz aufweise als eine andere, sind selten direkt vergleichbar. Manche beziehen sich auf den Port-zu-Port-Verlauf über einen Switch, andere auf den End-to-End-Verlauf zwischen Hosts, und nur selten wird angegeben, ob die Fabric ausgelastet oder überlastet war. Die IBTA führt als Argument für InfiniBand die extrem niedrige Latenz an, mit gemessenen Verzögerungen von 600 ns von Ende zu Ende,[1] Allerdings werden die Testbedingungen nicht angegeben, und die Ethernet-Ergebnisse hängen vom Switch, der Netzwerkkarte, der Konfiguration und dem Datenverkehrsmuster ab.
Für das KI-Training sagt ein einzelner Latenzwert wenig aus. Bei Trainingsaufträgen werden die GPUs immer wieder synchronisiert, sodass der gesamte Auftrag auf die langsamste Übertragung wartet und bereits eine überlastete Verbindung zum Engpass werden kann. Der Durchsatz unter Last ist ebenso wichtig wie die Latenz. Im RoCE-Netzwerk von Meta verlangsamten Datenflüsse, die nach einem Verbindungsausfall aufeinanderprallten, den gesamten Trainingsjob, und das erklärte Ziel der Überlastungsmaßnahmen war eine vorhersehbare Tail-Latenz. Ein fairer Vergleich ist die Job-Durchlaufzeit auf Ihrer eigenen Topologie mit Ihrer eigenen Arbeitslast. Unsere Leitfaden zum GPU-Netzwerk behandelt die häufigsten Ursachen für langsamen Datenverkehr beim Training.
Ethernet vs. InfiniBand: Was passt besser zu Ihrem KI-Cluster?
Beide Netzwerke dienen denselben Anwendungsfällen – groß angelegtes KI-Training und HPC –, sodass bei der Entscheidung zwischen Ethernet und InfiniBand keine der beiden Technologien in jedem Fall die Oberhand gewinnt. NVIDIA selbst veröffentlicht Referenzdesigns für beide. Die DGX SuperPOD H100-Architektur nutzt InfiniBand als Rechen-Fabric und ebenfalls eine InfiniBand-Netzwerk-Fabric für den Speicher, während die Unternehmens-Referenzarchitektur für GB300 NVL72 Spectrum-X-Ethernet als Rechen-Fabric verwendet.
| Wenn dies auf Ihr Projekt zutrifft | Es deutet darauf hin, dass | Warum |
|---|---|---|
| Sie stellen ein Referenzdesign eines Anbieters in der veröffentlichten Form bereit | Was auch immer in diesem Entwurf festgelegt ist | Schalter, Kabel und Längen werden gemeinsam geprüft |
| Ihr Team nutzt bereits Ethernet in großem Umfang und bezieht die Produkte von mehreren Anbietern | Ethernet mit RoCE | Dieselben Werkzeuge, Kompetenzen und Lieferketten wie im restlichen Netzwerk |
| Sie möchten eine Architektur, die von Anfang an für verlustfreies RDMA ausgelegt ist | InfiniBand | Weniger Anpassungen an den Einstellungen für die Durchflussregelung und die Überlastungssteuerung |
| Der Cluster wird die Vermittlung des Front-End- oder Speicherverkehrs gemeinsam übernehmen. | Ethernet mit RoCE | Eine einheitliche Vermittlungstechnologie für alle Netzwerke |
| Mehrere tausend GPUs oder mehr | Entweder | Beide haben in veröffentlichten Implementierungen oder Entwürfen ihre Skalierbarkeit unter Beweis gestellt. |
Der Markt entwickelt sich in Richtung Ethernet. Die Dell’Oro Group berichtete im Juli 2025, dass InfiniBand bei Beginn ihrer Erhebungen Ende 2023 einen Anteil von über 80 Prozent an den Backend-Netzwerken für KI hatte und dass Ethernet nun in diesem Segment die Oberhand gewinnt.[3] Das ist eine Marktprognose und keine Entscheidung bezüglich eines bestimmten Clusters. Beide Produktreihen werden weiterhin verkauft und unterstützt.

Bedeutet ein Wechsel der Switch-Struktur auch eine neue Glasfaserverkabelung?
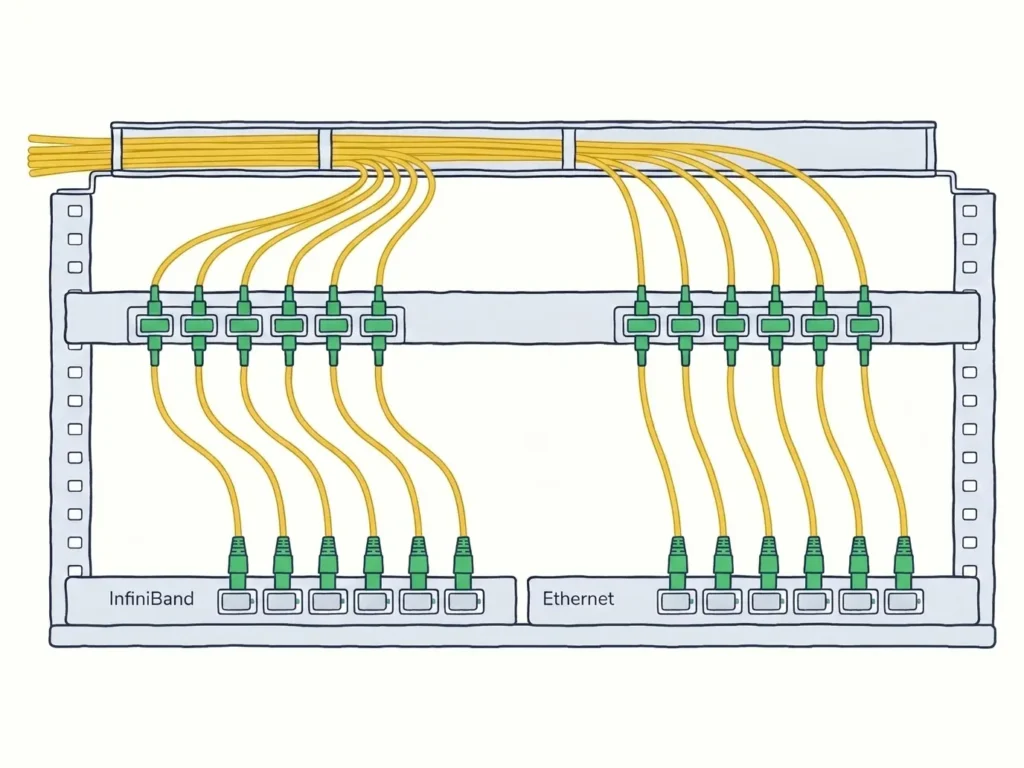
Meistens nicht, solange man innerhalb derselben Geschwindigkeitsgeneration und derselben optischen Schnittstelle bleibt. Das Protokoll ist in den Switches und teilweise in der Firmware der Transceiver implementiert. Die Steckverbinder, Glasfaserkabel und Patchfelder sind passiv: Sie übernehmen die Datenübertragung, ohne zu wissen, welches Protokoll sie übertragen. Auch die Portbandbreite ist in dieser Generation auf beiden Seiten gleich und beträgt 400 Gb/s pro Port. Hier ist die Darstellung Schicht für Schicht für die 400G-Generation (100G-PAM4) von NVIDIA:
| Ebene | Gibt es Änderungen am Protokoll? | Was in der Dokumentation des Anbieters steht |
|---|---|---|
| Schalter | Ja | NVIDIA Quantum-2 NDR InfiniBand und Spectrum-4 SN5600 Ethernet sind separate Switch-Produktreihen, doch beide verwenden OSFP-Einschübe mit zwei Anschlüssen, die jeweils zwei 400-Gb/s-Ports aufnehmen. |
| Netzwerkkarten | Normalerweise nicht | ConnectX-7 unterstützt beide Protokolle auf derselben Karte, wobei die Aktivierung durch den InfiniBand- oder Ethernet-Switch erfolgt, an den die Karte angeschlossen ist; einige ConnectX-6- und BlueField-2-Adapter sind protokollspezifisch |
| Sende-Empfänger | Überprüfen Sie die Artikelnummer | Die ursprünglichen NDR/400GbE-Transceiver unterstützen beide Protokolle, und ihre Firmware aktiviert das Protokoll des Switches; neuere Versionen, die ausschließlich für Ethernet ausgelegt sind, enden auf “-T”.”[4] |
| Steckverbinder | Nein | MPO-12/APC: acht Fasern im Einsatz, vier Steckplätze frei |
| Glasfaserkabel | Nein | NVIDIA gibt an, dass für seine NDR- und neueren Optikmodule dieselben Glasfaserkabel verwendet werden. |
| Patchfelder und Sammelkabel | Nein | Die Reichweitenangaben für diese Optiken gehen von zwei optischen Patchfeldern in der Verbindung aus |
| DAC- und AOC-Kabel | Überprüfen Sie die Artikelnummer | Vergewissern Sie sich, dass jedes Kabelteil für den jeweiligen Switch und die jeweilige Geschwindigkeit zugelassen ist; einige ältere Adapter erfordern protokollspezifische Kabel. |
Die optische Schnittstelle wird durch den Transceiver festgelegt, nicht durch das Protokoll. Diese Optiken der NVIDIA 400G-Generation veranschaulichen das Muster:
| Teil | Formfaktor | Anschluss | Faser | Reichweite |
|---|---|---|---|---|
| MMS4X00-NS | OSFP mit zwei Anschlüssen (2 × 400G) | 2 × MPO-12/APC | Single-Mode, 1310 nm | Bis zu 100 m |
| MMS4X00-NM | OSFP mit zwei Anschlüssen (2 × 400G) | 2 × MPO | Single-Mode, 1310 nm | Bis zu 500 m |
| MMA4Z00-NS | OSFP mit zwei Anschlüssen (2 × 400G) | 2 × MPO-12/APC | Multimode, 850 nm | Bis zu 50 m |
| MMA1Z00-NS400 | QSFP112 (400G) | MPO-12/APC | Multimode, 850 nm | Bis zu 50 m |
Was bleibt erhalten und was nicht
Innerhalb einer Generation und einer optischen Schnittstelle kann die strukturierte Glasfaseranlage (MPO-12/APC-Trunks, Patchfelder und Patchkabel) unverändert bleiben. Die Switches werden ausgetauscht. Bei Transceivern, DAC- und AOC-Kabeln muss die Artikelnummer überprüft werden, und die Kabellängen sollten anhand des neuen Referenzdesigns überprüft werden. Das DGX SuperPOD H100-Design von NVIDIA begrenzt beispielsweise die Kabellänge jedes InfiniBand-Kabels auf 50 m.
Was die Faser tatsächlich verändert, ist ein Wechsel der optischen Schnittstelle. Sowohl eine Single-Mode-Verbindung vom Typ DR4 als auch eine Multimode-Verbindung vom Typ SR4 verwenden MPO-12/APC, doch Single-Mode- und Multimode-Fasern können nicht gegeneinander ausgetauscht werden. Unsere Leitfaden zum 400G-Netzwerk listet die Glasfasern auf, die für jede 400G-Glasfaserverbindung benötigt werden, und unsere MPO/MTP-Patchkabel beide Fasertypen abdecken.

Umstellung oder paralleler Betrieb: Eine Checkliste für die Verkabelung
- Überprüfen Sie jede Teilenummer der Funkgeräte. Vergewissern Sie sich, dass das Gerät das gewünschte Protokoll unterstützt; es gibt auch reine Ethernet-Versionen.
- Behalten Sie die optische Schnittstelle bei. Verwenden Sie die Faser nur dann wieder, wenn das neue optische Bauteil denselben Stecker und denselben Fasertyp (Single-Mode oder Multimode) verwendet.
- APC durchgehend beibehalten. APC- und UPC-Stecker sollten nicht miteinander verbunden werden.
- Halten Sie sich an die Ein-Polaritäts-Methode. Die optischen Direktkabel von NVIDIA sind gerade Crossover-Kabel vom Typ B (MPO-12/APC).
- Prüfen Sie die Stämme, die Sie behalten, erneut. Messen Sie die Einfügungsdämpfung und vergleichen Sie diese mit dem Kanalgrenzwert, beispielsweise 3,0 dB für 400GBASE-DR4.[5]
- Überprüfen Sie die Längen erneut anhand des neuen Referenzentwurfs. Längenbeschränkungen sind bei jedem Entwurf unterschiedlich.
- Plane die nächste Geschwindigkeit. Die XDR-Switch-Gehäuse von NVIDIA sind aus Gründen der Abwärtskompatibilität auch mit NDR-Kabeln und -Transceivern kompatibel. Eine 16-Faser-Schnittstelle wie 800GBASE-DR8 benötigt 16 Fasern pro Port.
Wo Ultra-Ethernet zum Einsatz kommt
Das Ultra Ethernet Consortium (UEC) ist eine auf Konsens basierende Standardisierungsorganisation, die unter dem Dach der Linux Foundation tätig ist und am 11. Juni 2025 die Ultra-Ethernet-Spezifikation 1.0 veröffentlichte.[6] Das Ziel besteht darin, Ethernet besser für KI- und HPC-Datenverkehr geeignet zu machen. Es handelt sich um eine neue Spezifikation im Bereich der KI-Netzwerke, die bislang noch keine Alternative zu InfiniBand oder RoCE darstellt; daher basiert die KI-Infrastruktur vorerst weiterhin auf einer dieser beiden Technologien. Wenn Sie heute eine Fabric planen, fragen Sie Ihre Switch- und Netzwerkkartenanbieter, welche UEC-Funktionen ihre Produkte unterstützen und ob vorhandene optische Komponenten und Verkabelungen weiterverwendet werden können.
MPO-Glasfaserverbindungen für InfiniBand- und Ethernet-Cluster
MPO/MTP-Patch-Kabel: MPO/MTP-Stammkabel und Patchkabel in Single-Mode- und Multimode-Ausführung für 400G- und 800G-Verbindungen. MPO-/MTP-Kabel anzeigen
Die oben beschriebenen passiven Verbindungen funktionieren bei beiden Fabric-Typen gleich und werden von YingFeng geliefert. Unsere MPO/MTP-Patchkabel Erhältlich als OS2-Singlemode- und OM3- oder OM4-Multimode-Ausführungen mit APC- oder UPC-Endflächen in Varianten mit 8, 12, 16 und 24 Fasern; verlustarme Ausführungen sind verfügbar. MPO/MTP-Baugruppen werden in einem Reinraum hergestellt, und Muster sind auf Anfrage erhältlich. Weitere passive Komponenten finden Sie in unserem Glasfasertechnik für Rechenzentren. Um ein Angebot zu erhalten, Sag es uns die Teilenummern der Transceiver, die Verbindungslängen und die Polaritätsmethode.
Häufig gestellte Fragen
Ist InfiniBand eine Kupfer- oder Glasfaserverbindung?
Beides. Für kurze Verbindungen innerhalb eines Racks werden häufig Kupferkabel mit Direktanschluss verwendet, während für längere Verbindungen aktive optische Kabel oder Transceiver mit Glasfaser zum Einsatz kommen. In der 400G-Generation verwenden die Transceiver MPO-12/APC-Stecker über Singlemode- oder Multimode-Glasfaser.
Verwendet NVIDIA InfiniBand oder Ethernet?
Beides. NVIDIA vertreibt Quantum-InfiniBand-Switches und Spectrum-Ethernet-Switches, veröffentlicht für beide Referenzdesigns, und seine ConnectX-7-Netzwerkkarten unterstützen beide Protokolle.
Können dieselben Glasfaserkabel sowohl für InfiniBand als auch für Ethernet verwendet werden?
Ja, innerhalb derselben Generation und derselben optischen Schnittstelle. Die MPO-12/APC-Stecker und die Glasfaser sind identisch; es muss lediglich geprüft werden, ob jeder Transceiver das gewünschte Protokoll unterstützt. Siehe Bedeutet ein Wechsel der Switch-Struktur auch eine neue Glasfaserverkabelung? für die vollständige Aufschlüsselung.
Was ist RoCE?
RoCE (RDMA over Converged Ethernet) ist ein von der IBTA definierter Industriestandard für den Datentransport, der den Einsatz von RDMA in herkömmlichen Ethernet-Netzwerken der Schichten 2 und 3 ermöglicht. Die erste Spezifikation wurde 2010 veröffentlicht.
Ersetzt Ethernet InfiniBand?
Laut dem Bericht der Dell’Oro Group vom Juli 2025 hat Ethernet in AI-Backend-Netzwerken seit Ende 2023 rasch an Marktanteil gewonnen. Sowohl Ethernet als auch InfiniBand werden nach wie vor verkauft und eingesetzt, und NVIDIA veröffentlicht Referenzdesigns für beide Technologien.
Externe Verweise
- InfiniBand Trade Association: Über InfiniBand
- Gangidi et al., „RDMA over Ethernet für verteiltes KI-Training im Meta-Maßstab“, ACM SIGCOMM 2024: ACM Digital Library
- Dell’Oro Group: Ethernet gewinnt den Kampf gegen InfiniBand in KI-Backend-Netzwerken (Pressemitteilung, 15. Juli 2025)
- NVIDIA: LinkX-Kabel und -Transceiver mit 400 Gb/s – Hauptseite (Produktdokumentation)
- TIA-Konsortium für Glasfasertechnologie: 400GBASE-DR4 – Anwendungsübersicht
- Ultra-Ethernet-Konsortium: Ultra-Ethernet-Spezifikation v1.0 (11. Juni 2025)